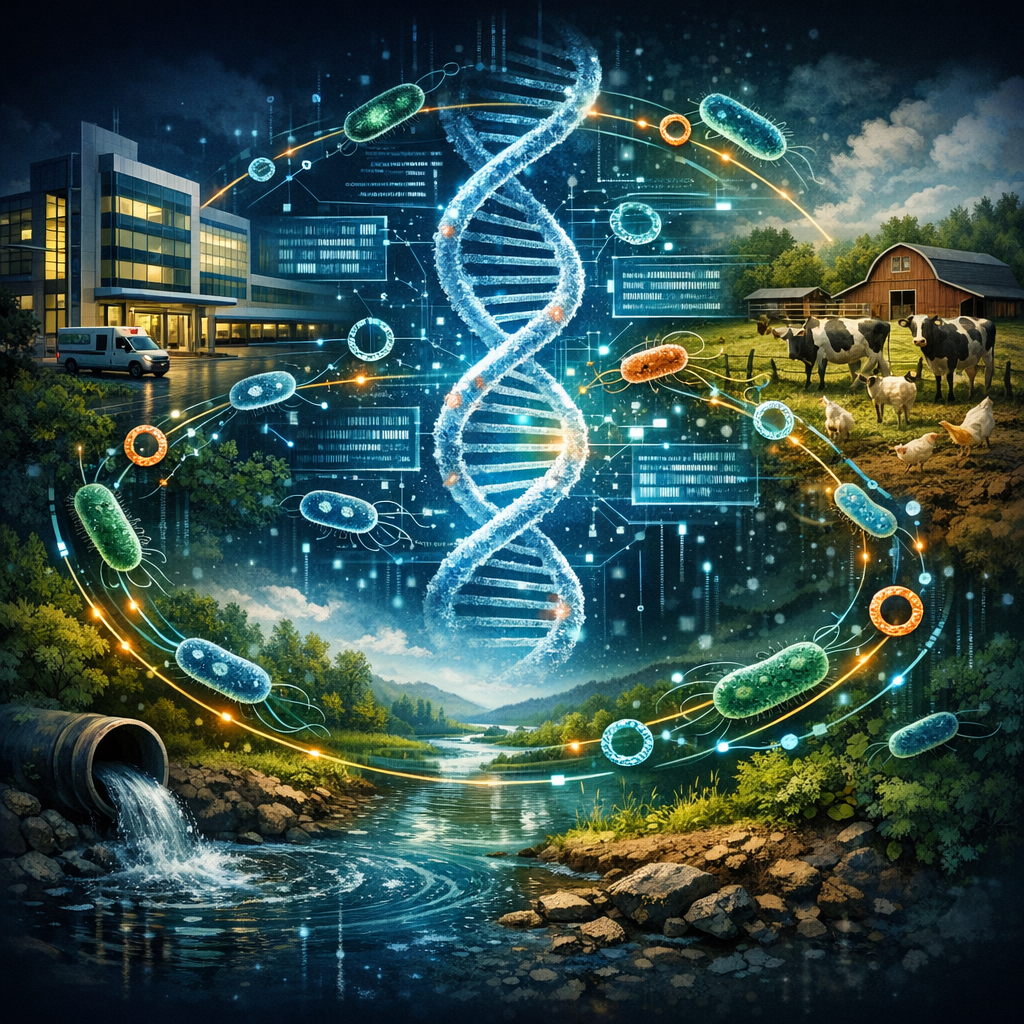
Génomique computationnelle : mieux comprendre le réservoir de résistance aux antibiotiques selon l’approche One Health
Génomique computationnelle : mieux comprendre le réservoir de résistance aux antibiotiques selon l’approche One Health
La résistance aux antibiotiques constitue l’un des défis majeurs de la santé publique mondiale. Elle ne se limite pas aux établissements de soins ou aux bactéries responsables d’infections humaines : les gènes de résistance circulent également chez les animaux, dans les sols, les eaux usées, les aliments et de nombreux autres écosystèmes.
Dans ce contexte, l’approche One Health, ou « une seule santé », propose d’étudier conjointement la santé humaine, la santé animale et la santé des écosystèmes. Les progrès de la génomique computationnelle apportent aujourd’hui des outils essentiels pour cartographier ce réservoir de résistance, suivre la circulation des gènes et mieux anticiper l’apparition de nouvelles menaces.
Un réservoir de résistance réparti dans de nombreux milieux
Les bactéries échangent naturellement du matériel génétique. Parmi ces éléments figurent les gènes de résistance aux antimicrobiens, qui peuvent être portés par les chromosomes ou par des éléments génétiques mobiles, comme les plasmides, les transposons et les intégrons.
Ces mécanismes favorisent la diffusion de la résistance entre bactéries parfois très éloignées sur le plan taxonomique. Les antibiotiques utilisés en médecine humaine, en élevage ou dans certains environnements peuvent exercer une pression de sélection qui favorise la survie et la multiplication des microorganismes résistants.
Le réservoir de résistance comprend ainsi :
- les bactéries pathogènes responsables d’infections ;
- les microorganismes commensaux présents chez l’être humain et l’animal ;
- les bactéries environnementales ;
- les gènes de résistance présents dans les eaux usées, les sols et les sédiments ;
- les éléments génétiques capables de transférer ces gènes d’une bactérie à une autre.
L’enjeu consiste donc à dépasser l’analyse isolée d’un seul patient ou d’un seul établissement pour reconstituer les réseaux de circulation de la résistance à l’échelle des populations et des écosystèmes.
Le rôle de la génomique computationnelle
La génomique computationnelle regroupe les méthodes informatiques utilisées pour analyser de grandes quantités de données biologiques. Associée au séquençage à haut débit, elle permet d’examiner simultanément des milliers, voire des millions de fragments d’ADN issus d’un échantillon.
Ces approches peuvent être appliquées à des bactéries isolées en laboratoire, mais aussi à des échantillons complexes contenant de nombreux microorganismes. Elles offrent notamment la possibilité de :
- détecter les gènes associés à la résistance ;
- identifier les espèces et les souches bactériennes présentes ;
- déterminer les mutations susceptibles de modifier la sensibilité aux antibiotiques ;
- caractériser les plasmides et autres éléments génétiques mobiles ;
- comparer des génomes provenant de sources humaines, animales et environnementales ;
- suivre la transmission de clones résistants ou de gènes particuliers.
La puissance de ces analyses repose sur l’utilisation de bases de données spécialisées, d’algorithmes de comparaison de séquences et de pipelines bioinformatiques capables de traiter des données hétérogènes.
Métagénomique : analyser les communautés microbiennes dans leur ensemble
La métagénomique consiste à séquencer directement l’ADN contenu dans un échantillon, sans devoir cultiver au préalable les microorganismes. Cette méthode est particulièrement utile pour étudier des milieux complexes, tels que les eaux usées, le microbiote intestinal, les sols agricoles ou les effluents hospitaliers.
Elle permet de dresser un inventaire des gènes de résistance aux antibiotiques, parfois désignés sous le terme d’« antibiotic resistome ». Cet ensemble peut comprendre des gènes présents dans des bactéries non pathogènes, mais susceptibles d’être transférés ultérieurement à des microorganismes responsables d’infections.
La métagénomique permet également d’identifier des résistances difficiles à observer avec les méthodes classiques de culture. Elle fournit donc une vision plus large de la diversité génétique présente dans un environnement donné.
Relier les données génomiques aux sources de contamination
L’un des principaux intérêts de la génomique computationnelle est de comparer les profils de résistance provenant de différents compartiments. Des analyses croisées peuvent être menées entre :
- des isolats cliniques ;
- des élevages et des animaux domestiques ;
- des aliments ;
- des eaux usées urbaines ou hospitalières ;
- des stations de traitement ;
- des rivières, des sols et des milieux côtiers.
Ces comparaisons peuvent aider à déterminer si un gène de résistance est limité à un environnement ou s’il circule entre plusieurs secteurs. Elles peuvent aussi contribuer à repérer des voies de transmission potentielles, sans pour autant prouver à elles seules qu’un transfert direct a eu lieu.
L’interprétation doit donc combiner les informations génomiques avec les données épidémiologiques, microbiologiques, géographiques et environnementales.
Les principales étapes d’une analyse bioinformatique
Une étude de génomique computationnelle suit généralement plusieurs étapes :
- Collecte et préparation des échantillons : les prélèvements doivent être représentatifs et accompagnés de métadonnées fiables.
- Séquençage de l’ADN : différentes technologies peuvent être utilisées selon la longueur des séquences recherchées et le niveau de précision attendu.
- Contrôle de qualité : les données sont nettoyées afin de retirer les séquences trop courtes, contaminées ou de mauvaise qualité.
- Assemblage et annotation : les fragments sont reconstitués puis comparés à des références connues.
- Détection des gènes de résistance : des outils spécialisés recherchent les signatures génétiques associées à différents mécanismes de résistance.
- Analyse de la mobilité génétique : la présence de plasmides, d’intégrons ou de transposons est étudiée pour évaluer le potentiel de diffusion.
- Comparaison des génomes : les profils obtenus sont confrontés à d’autres échantillons afin d’identifier des similitudes et des liens possibles.
- Interprétation biologique et épidémiologique : les résultats sont replacés dans leur contexte pour éviter les conclusions excessives.
Des outils puissants, mais des limites persistantes
La génomique computationnelle ne fournit pas automatiquement une réponse complète sur le risque clinique ou épidémiologique. Plusieurs difficultés doivent être prises en compte.
Une grande diversité de méthodes
Les laboratoires n’utilisent pas toujours les mêmes protocoles d’échantillonnage, plateformes de séquençage, seuils de détection ou bases de données. Cette hétérogénéité complique la comparaison des résultats entre études et entre pays.
La présence d’un gène ne signifie pas toujours une résistance fonctionnelle
La détection d’un gène associé à la résistance ne permet pas nécessairement de conclure qu’une bactérie est résistante à un antibiotique dans les conditions cliniques. L’expression du gène, son environnement génétique et d’autres mécanismes biologiques peuvent modifier son effet.
Des bases de données encore incomplètes
Les bases de référence sont indispensables, mais elles peuvent contenir des annotations incertaines ou ne pas couvrir toute la diversité des gènes existants. Des mécanismes nouveaux ou très éloignés des séquences connues peuvent ainsi être difficiles à détecter.
La difficulté d’attribuer une source
La similarité entre deux séquences indique une proximité génétique, mais ne permet pas toujours d’identifier précisément le sens de la transmission. La distinction entre corrélation, origine commune et transfert direct nécessite des données complémentaires.
La protection des données
Les analyses liées aux patients, aux établissements de soins ou aux exploitations agricoles doivent respecter des exigences strictes en matière de confidentialité, de gouvernance des données et de partage des informations.
Vers une surveillance intégrée de la résistance
Pour être pleinement utile, la génomique computationnelle doit s’inscrire dans des systèmes de surveillance coordonnés. Une stratégie One Health efficace suppose de rapprocher les données issues de la médecine humaine, de la médecine vétérinaire et de l’environnement.
Cette intégration peut permettre :
- de détecter plus rapidement l’émergence de profils de résistance préoccupants ;
- de suivre la diffusion de bactéries ou de plasmides à risque ;
- d’améliorer la surveillance des eaux usées ;
- d’évaluer l’impact des pratiques d’utilisation des antibiotiques ;
- de cibler les mesures de prévention et de contrôle ;
- de soutenir les politiques de bon usage des antimicrobiens.
Les systèmes de surveillance devront également favoriser la standardisation des données, l’interopérabilité des plateformes et la formation de professionnels capables de travailler à la croisée de la microbiologie, de la bioinformatique, de l’épidémiologie et des sciences environnementales.
L’intelligence artificielle comme outil complémentaire
L’augmentation du volume des données génomiques stimule l’utilisation de méthodes d’apprentissage automatique et d’intelligence artificielle. Ces techniques peuvent contribuer à repérer des motifs complexes, à classer des séquences inconnues ou à prédire certaines associations entre mutations et phénotypes de résistance.
Cependant, ces modèles dépendent fortement de la qualité des données utilisées pour leur entraînement. Ils doivent être évalués sur des jeux de données indépendants et interprétés avec prudence. L’intelligence artificielle ne remplace ni la validation expérimentale ni l’expertise des microbiologistes et des épidémiologistes.
Une approche indispensable pour anticiper les risques
La résistance aux antibiotiques est un phénomène dynamique, alimenté par les échanges entre les populations humaines, animales et microbiennes. En étudiant les gènes de résistance, leur contexte génétique et leur circulation entre les milieux, la génomique computationnelle apporte une vision plus complète du problème.
Son principal intérêt réside dans sa capacité à relier des informations qui étaient autrefois analysées séparément. Elle peut ainsi aider à identifier les réservoirs de résistance, à repérer les voies de transmission potentielles et à améliorer la surveillance à long terme.
Pour transformer ces données en décisions concrètes, plusieurs conditions restent essentielles : harmoniser les méthodes, renforcer le partage des données, valider les résultats en laboratoire et inscrire les analyses dans une véritable gouvernance One Health. La combinaison de ces approches constitue un levier important pour préserver l’efficacité des antibiotiques et limiter l’impact des résistances sur la santé mondiale.