Archive d’étiquettes pour : apprentissage automatique

Imagerie hyperspectrale dans l’agroalimentaire : l’intelligence artificielle au service de la qualité et de la sécurité

Imagerie hyperspectrale dans l’agroalimentaire : l’intelligence artificielle au service de la qualité et de la sécurité

Le secteur agroalimentaire cherche en permanence à améliorer la qualité, la sécurité et la traçabilité des produits. Dans ce contexte, l’imagerie hyperspectrale s’impose comme une technologie prometteuse. Associée à l’apprentissage automatique, elle permet d’analyser les aliments de manière rapide, non destructive et particulièrement détaillée.

Cette combinaison technologique ouvre la voie à des contrôles plus fiables, capables de détecter des défauts invisibles à l’œil nu, d’identifier certains risques sanitaires et d’évaluer la composition des produits tout au long de la chaîne alimentaire.

Qu’est-ce que l’imagerie hyperspectrale ?

L’imagerie hyperspectrale combine les principes de la photographie et de la spectroscopie. Contrairement à une image classique, qui repose généralement sur trois canaux de couleur, elle enregistre un grand nombre de bandes spectrales pour chaque pixel.

Chaque aliment possède une « signature » spectrale liée à sa composition chimique et à son état. La teneur en eau, en matières grasses, en protéines ou en pigments peut ainsi influencer la manière dont la lumière est absorbée ou réfléchie.

L’image obtenue contient donc deux types d’informations :

  • des informations spatiales, qui indiquent où se trouvent les différentes caractéristiques sur le produit ;
  • des informations spectrales, qui renseignent sur sa composition et son état.

Cette richesse de données permet d’examiner simultanément l’apparence et certaines propriétés internes de l’aliment, sans avoir à le découper ni à le détruire.

Le rôle de l’apprentissage automatique

Les systèmes hyperspectraux génèrent des volumes importants de données. Leur interprétation nécessite donc des méthodes capables de repérer des relations complexes entre les signatures spectrales et les caractéristiques recherchées.

C’est le rôle de l’apprentissage automatique. Les modèles sont entraînés à partir d’échantillons connus afin d’apprendre à :

  • classer les produits selon leur qualité ou leur origine ;
  • estimer leur composition ;
  • repérer des défauts visuels ou internes ;
  • identifier des signes de contamination ;
  • prédire la durée de conservation ;
  • détecter les phénomènes de dégradation ou de maturité.

Les approches utilisées peuvent inclure des méthodes statistiques classiques, des algorithmes de classification et des réseaux neuronaux profonds. Les modèles de deep learning sont particulièrement intéressants lorsqu’il faut analyser des images complexes ou traiter plusieurs sources de données simultanément.

Des applications variées dans les systèmes alimentaires

Contrôle de la qualité des produits frais

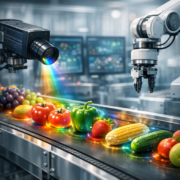
Pour les fruits et les légumes, l’imagerie hyperspectrale peut contribuer à évaluer le degré de maturité, la fermeté, la teneur en eau ou encore la présence de lésions. Elle peut également aider à distinguer les produits sains de ceux présentant des signes de détérioration.

Cette détection précoce facilite le tri, limite les pertes et permet d’orienter les produits vers les circuits de distribution appropriés.

Détection des contaminations

La sécurité alimentaire constitue l’un des principaux domaines d’application. Les systèmes hyperspectraux peuvent être entraînés pour repérer des anomalies associées à certains agents biologiques, à des contaminations de surface ou à la présence de corps étrangers.

La technologie ne remplace pas nécessairement les analyses microbiologiques de référence, mais elle peut jouer un rôle de présélection rapide. Les lots présentant un risque peuvent ensuite être soumis à des contrôles complémentaires plus ciblés.

Identification des défauts et des dommages

Les défauts mécaniques, les moisissures, les brûlures, les taches et les altérations liées au stockage ne sont pas toujours visibles au premier regard. L’imagerie hyperspectrale peut révéler des différences subtiles entre une zone saine et une zone endommagée.

Intégrée à une ligne de production, elle peut automatiser une partie du tri et améliorer la régularité des contrôles.

Authentification et lutte contre la fraude

L’analyse spectrale peut également contribuer à vérifier l’authenticité d’un produit, son origine ou sa conformité à une déclaration d’étiquetage. Elle offre notamment des possibilités pour détecter certaines substitutions, dilutions ou mélanges non déclarés.

Dans un contexte où les chaînes d’approvisionnement sont de plus en plus complexes, ces outils peuvent renforcer la traçabilité et la confiance des consommateurs.

Suivi de la transformation et du stockage

Les propriétés des aliments évoluent au cours de la transformation et de la conservation. L’imagerie hyperspectrale peut suivre ces changements afin d’optimiser les paramètres de séchage, de cuisson, de fermentation ou d’emballage.

Elle peut aussi aider à prévoir la durée de vie restante d’un produit en analysant les marqueurs associés à son vieillissement.

Les principaux avantages de cette technologie

L’association de l’imagerie hyperspectrale et de l’apprentissage automatique présente plusieurs atouts :

  1. Une analyse non destructive : les produits peuvent être contrôlés sans être ouverts ni endommagés.
  2. Une mesure rapide : les systèmes peuvent être intégrés à des lignes de production automatisées.
  3. Une détection plus précoce : certaines anomalies sont repérées avant de devenir visibles.
  4. Une information spatialisée : les zones problématiques sont localisées directement sur le produit.
  5. Une réduction des erreurs humaines : les décisions reposent sur des mesures standardisées et des modèles entraînés.
  6. Une meilleure valorisation des données : l’analyse peut combiner les informations spectrales, visuelles et contextuelles.

Ces avantages doivent toutefois être évalués en fonction du coût des équipements, de la configuration de la chaîne de production et de la qualité des données disponibles.

Des limites encore importantes

Malgré son potentiel, l’imagerie hyperspectrale n’est pas une solution immédiatement universelle. Plusieurs obstacles doivent encore être pris en compte.

Le volume et la qualité des données

Les modèles d’apprentissage automatique ont besoin de bases de données suffisamment larges, représentatives et correctement annotées. Or, la composition des aliments peut varier selon la variété, l’origine, la saison, les conditions de stockage et les procédés de transformation.

Un modèle performant dans un laboratoire peut donc perdre en précision lorsqu’il est utilisé dans un autre environnement.

La standardisation des équipements

Les résultats peuvent être influencés par le type de caméra, l’éclairage, la distance d’acquisition, la température ou la vitesse du convoyeur. La standardisation des protocoles est essentielle pour obtenir des mesures comparables.

L’interprétabilité des modèles

Les réseaux neuronaux peuvent fournir des prédictions précises sans toujours expliquer clairement la logique suivie. Dans le domaine alimentaire, où les décisions peuvent avoir des conséquences sanitaires et économiques, la possibilité d’interpréter les résultats constitue un enjeu majeur.

Le coût et l’intégration industrielle

L’installation d’un système hyperspectral exige des équipements spécialisés, des compétences techniques et une infrastructure adaptée. Il faut également assurer la maintenance du dispositif et réentraîner les modèles lorsque les produits ou les conditions de production changent.

Vers des systèmes de contrôle plus intelligents

Les recherches s’orientent vers des solutions plus compactes, plus rapides et moins coûteuses. Les caméras hyperspectrales miniaturisées, les capteurs multispectraux et les systèmes embarqués pourraient faciliter le déploiement de cette technologie dans les entreprises de toutes tailles.

L’intégration avec l’internet des objets, la robotique et les plateformes de données devrait également permettre de suivre les produits en temps réel. Les informations recueillies pourraient être exploitées pour automatiser le tri, ajuster les procédés et améliorer la traçabilité.

Les modèles d’intelligence artificielle devront néanmoins être conçus avec une attention particulière portée à leur robustesse, à leur explicabilité et à leur capacité de généralisation.

Conclusion

L’imagerie hyperspectrale associée à l’apprentissage automatique constitue un outil majeur pour moderniser l’évaluation des aliments. Elle permet d’aller au-delà de l’inspection visuelle en fournissant des informations détaillées sur la composition, l’état et la qualité des produits.

Ses applications couvrent le contrôle des matières premières, la détection des contaminations, l’authentification, le suivi de la conservation et l’optimisation des procédés. Pour atteindre son plein potentiel, cette technologie devra toutefois s’appuyer sur des bases de données fiables, des protocoles standardisés et des modèles suffisamment transparents.

À terme, elle pourrait contribuer à rendre les systèmes alimentaires plus sûrs, plus efficaces et plus durables, tout en réduisant le gaspillage et les contrôles inutiles.
Détecter la contamination du riz par le cadmium grâce au proche infrarouge et à l’intelligence artificielle

Détecter la contamination du riz par le cadmium grâce au proche infrarouge et à l’intelligence artificielle

La contamination du riz par le cadmium constitue un enjeu important de sécurité alimentaire. Ce métal lourd peut être absorbé par les plants de riz à partir de sols ou d’eaux contaminés, puis s’accumuler dans les grains. Une consommation répétée de produits contenant des niveaux élevés de cadmium peut présenter des risques pour la santé, notamment pour les reins et le système osseux.

Les méthodes classiques de détection sont généralement fiables, mais elles nécessitent des analyses en laboratoire, des réactifs spécifiques et un temps de traitement parfois important. Dans ce contexte, une équipe de chercheurs a étudié une approche plus rapide et non destructive fondée sur la spectroscopie proche infrarouge, associée à des algorithmes d’apprentissage automatique.

Une méthode d’analyse rapide et non destructive

La spectroscopie proche infrarouge, ou NIRS (Near-Infrared Reflectance Spectroscopy), mesure la manière dont un échantillon réfléchit la lumière dans le domaine du proche infrarouge. Le signal obtenu contient des informations indirectes sur sa composition chimique et ses propriétés physiques.

Appliquée au riz, cette technologie permet d’analyser les grains sans les broyer ni les détruire. Elle pourrait donc être utilisée pour effectuer un contrôle rapide de lots de céréales, directement dans les centres de collecte, les unités de transformation ou les laboratoires de contrôle qualité.

Toutefois, le cadmium n’est pas toujours détectable directement par son empreinte spectrale. La concentration du métal doit généralement être estimée à partir des relations entre les données spectrales et les résultats d’analyses de référence. C’est précisément le rôle des modèles d’apprentissage automatique.

Le rôle de l’apprentissage automatique

Pour développer leur approche, les chercheurs ont associé les spectres obtenus par proche infrarouge à des concentrations de cadmium mesurées au moyen de méthodes analytiques conventionnelles. Ces données ont ensuite servi à entraîner différents modèles capables d’identifier les échantillons contaminés ou d’estimer leur niveau de contamination.

Avant la modélisation, les spectres peuvent être soumis à plusieurs opérations de prétraitement. La correction de la ligne de base, la normalisation ou encore la réduction du bruit permettent de limiter les variations liées à la taille des grains, à leur humidité ou aux conditions de mesure.

Les algorithmes d’apprentissage automatique recherchent ensuite les régularités présentes dans les données. Ils peuvent notamment être utilisés pour :

  • distinguer les échantillons présentant une contamination faible ou élevée ;
  • prédire la concentration de cadmium à partir du signal spectral ;
  • sélectionner les longueurs d’onde les plus informatives ;
  • améliorer la fiabilité des contrôles réalisés sur de nouveaux échantillons.

La performance de chaque modèle est évaluée à l’aide de données de validation distinctes de celles utilisées pour l’entraînement. Cette étape est essentielle pour vérifier que l’algorithme ne se contente pas de mémoriser les échantillons étudiés, mais qu’il peut réellement être appliqué à d’autres lots de riz.

Un potentiel pour le contrôle de la sécurité alimentaire

L’intérêt principal de cette méthode réside dans sa rapidité. Contrairement aux analyses chimiques traditionnelles, la spectroscopie proche infrarouge ne nécessite pas systématiquement de préparation complexe des échantillons. Elle peut également produire des mesures répétées à moindre coût et sans générer de déchets chimiques importants.

Associée à l’intelligence artificielle, elle pourrait constituer un outil de présélection efficace. Les lots identifiés comme suspects pourraient ensuite être soumis à une analyse de confirmation en laboratoire. Cette organisation permettrait de concentrer les méthodes les plus longues et les plus coûteuses sur les échantillons présentant le plus grand risque.

Une telle approche pourrait être particulièrement utile dans les régions où la culture du riz est exposée à la pollution des sols, à l’irrigation avec des eaux contaminées ou à la présence naturelle de cadmium dans l’environnement.

Des limites à prendre en compte

Malgré ses avantages, la technologie ne remplace pas encore les méthodes de référence. La précision des modèles dépend fortement de la qualité et de la diversité des échantillons utilisés pour leur apprentissage. Les différences entre les variétés de riz, les conditions de culture, l’humidité, l’origine géographique et les pratiques de stockage peuvent modifier les spectres mesurés.

Les modèles doivent donc être testés sur un nombre suffisamment large d’échantillons provenant de situations variées. Ils doivent également être régulièrement actualisés afin de rester fiables lorsque les conditions de production évoluent.

Par ailleurs, la spectroscopie proche infrarouge fournit principalement une estimation indirecte de la contamination. Une analyse chimique de confirmation reste nécessaire pour établir officiellement la conformité d’un lot et mesurer avec précision la concentration de cadmium.

Vers un dépistage plus accessible

L’étude met en évidence le potentiel de la combinaison entre spectroscopie proche infrarouge et apprentissage automatique pour accélérer la détection du cadmium dans le riz. Cette solution pourrait contribuer à rendre les contrôles plus fréquents, plus rapides et moins coûteux.

À terme, l’intégration de capteurs compacts, de modèles d’intelligence artificielle optimisés et d’outils de traitement automatisé pourrait faciliter le déploiement de systèmes de dépistage sur le terrain. Ces dispositifs ne remplaceraient pas les analyses réglementaires, mais ils offriraient un premier niveau de surveillance particulièrement utile pour la gestion des risques alimentaires.

La généralisation de cette technologie dépendra toutefois de la constitution de bases de données représentatives, de la validation des modèles dans des conditions réelles et de leur harmonisation avec les exigences des autorités sanitaires.

Évaluer la fraîcheur de la viande grâce à l’intelligence artificielle

L’intelligence artificielle au service de la fraîcheur de la viande

L’évaluation de la fraîcheur de la viande repose encore largement sur des contrôles sensoriels, microbiologiques et chimiques. Ces méthodes restent indispensables, mais elles peuvent être longues, coûteuses et parfois dépendantes de l’expérience de l’opérateur. Face à ces limites, l’intelligence artificielle ouvre la voie à des solutions rapides, non destructives et automatisées.

L’approche présentée dans l’article s’appuie sur l’intégration de technologies de détection, de modèles d’apprentissage automatique et de systèmes de surveillance intelligents. L’objectif est de mieux suivre l’évolution de la qualité de la viande, depuis la production jusqu’à la commercialisation.

Des capteurs pour observer les signes de dégradation

La fraîcheur d’un produit carné évolue sous l’effet de nombreux facteurs : température, durée de stockage, humidité, exposition à l’oxygène et activité microbienne. Ces changements peuvent modifier la couleur, l’odeur, la texture et la composition chimique de la viande.

Pour les détecter, plusieurs technologies peuvent être utilisées :

  • la vision par ordinateur, qui analyse la couleur, l’aspect de la surface et les changements visuels ;
  • la spectroscopie, capable d’identifier certaines variations liées à la composition du produit ;
  • les nez électroniques, conçus pour détecter les composés volatils associés à l’altération ;
  • les capteurs de gaz, qui surveillent les molécules libérées au cours de la dégradation ;
  • les dispositifs intelligents et connectés, qui enregistrent en continu la température et les conditions de conservation.

Ces outils produisent un grand volume de données. Leur exploitation nécessite donc des méthodes capables de reconnaître des tendances complexes et de distinguer les différents niveaux de fraîcheur.

Le rôle de l’apprentissage automatique

Les algorithmes d’apprentissage automatique sont entraînés à partir de données associant des mesures provenant des capteurs à des indicateurs de référence, tels que la charge microbienne, le pH, la perte de qualité ou la durée de conservation.

Une fois entraînés, ces modèles peuvent :

  • classer les échantillons selon leur niveau de fraîcheur ;
  • repérer les premiers signes d’altération ;
  • estimer la durée de conservation restante ;
  • détecter des anomalies dans une chaîne du froid ;
  • automatiser une partie des contrôles qualité.

Les méthodes d’apprentissage profond, notamment les réseaux neuronaux convolutifs, sont particulièrement adaptées à l’analyse d’images. D’autres modèles peuvent exploiter des données spectrales, olfactives ou environnementales. La combinaison de plusieurs sources d’information permet d’obtenir une évaluation plus complète qu’un seul indicateur pris isolément.

Vers une surveillance en temps réel

L’un des principaux intérêts de ces technologies réside dans leur capacité à fonctionner en continu. Des capteurs installés dans les chambres froides, les véhicules de transport ou les rayons de distribution peuvent transmettre des données à une plateforme centralisée.

Un système intelligent peut alors suivre l’historique thermique d’un lot, identifier une rupture de la chaîne du froid et générer une alerte avant que la qualité du produit ne se dégrade de manière irréversible. Cette surveillance permettrait également d’améliorer la rotation des stocks et de limiter les pertes alimentaires.

Dans les usines de transformation, l’analyse automatisée pourrait contribuer à standardiser les contrôles entre différents sites et à réduire la dépendance aux inspections manuelles. Les informations recueillies peuvent aussi renforcer la traçabilité, à condition d’être correctement associées aux lots concernés.

Des avantages pour toute la chaîne alimentaire

L’intégration de l’intelligence artificielle présente plusieurs bénéfices potentiels :

  1. Des contrôles plus rapides : les résultats peuvent être obtenus en quelques secondes ou minutes, selon la technologie employée.
  2. Une analyse non destructive : certains dispositifs évaluent le produit sans l’endommager.
  3. Une meilleure régularité : les modèles appliquent les mêmes critères à l’ensemble des échantillons.
  4. Une réduction du gaspillage : une estimation plus précise de la durée de conservation peut éviter la mise au rebut prématurée de produits encore consommables.
  5. Une amélioration de la sécurité alimentaire : la détection précoce des anomalies facilite la mise en place d’actions correctives.
  6. Une optimisation de la logistique : les données peuvent aider à ajuster les conditions de transport et de stockage.

Des limites encore importantes

Malgré ces perspectives, le déploiement de ces solutions nécessite de résoudre plusieurs difficultés. Les modèles d’intelligence artificielle dépendent fortement de la qualité et de la diversité des données utilisées pour leur entraînement. Une base de données constituée dans un seul environnement peut être moins fiable lorsqu’elle est appliquée à d’autres races animales, découpes, emballages ou conditions de stockage.

La calibration des capteurs constitue également un enjeu majeur. Les variations de température, d’humidité, de lumière ou de conditionnement peuvent influencer les mesures. Il est donc nécessaire de tester les dispositifs dans des conditions proches de celles rencontrées sur le terrain.

La question de l’interprétabilité reste elle aussi centrale. Dans le secteur alimentaire, les professionnels doivent pouvoir comprendre les raisons d’une alerte ou d’une classification. Les systèmes ne devraient pas remplacer complètement les méthodes de référence, mais plutôt les compléter et aider les experts à prendre des décisions plus rapides.

Enfin, le coût du matériel, l’interopérabilité entre les plateformes et la protection des données peuvent ralentir l’adoption de ces technologies par les entreprises, en particulier les plus petites.

Une technologie complémentaire aux méthodes traditionnelles

L’intelligence artificielle ne constitue pas une solution isolée. Son efficacité dépend de son intégration dans un protocole global associant bonnes pratiques d’hygiène, contrôle de la température, analyses microbiologiques et traçabilité. Les méthodes de référence restent nécessaires pour valider les performances des systèmes automatisés et garantir leur conformité réglementaire.

À terme, les dispositifs les plus performants seront probablement ceux qui combinent plusieurs types de données : images, signaux spectraux, composés volatils, température, humidité et historique logistique. Cette approche multimodale peut offrir une vision plus précise de l’état réel de la viande et améliorer la fiabilité des prédictions.

Conclusion

L’évaluation de la fraîcheur de la viande évolue vers des systèmes plus rapides, connectés et prédictifs. En associant capteurs, apprentissage automatique et surveillance en temps réel, l’intelligence artificielle peut renforcer le contrôle qualité, réduire le gaspillage et améliorer la gestion de la chaîne du froid.

Son adoption devra toutefois s’accompagner de validations rigoureuses, de données représentatives et d’une supervision humaine. Utilisée comme un outil d’aide à la décision, elle pourrait devenir un maillon essentiel d’une chaîne alimentaire plus sûre, plus transparente et plus efficace.

Système d’alerte précoce par apprentissage automatique : anticiper l’impact du changement climatique sur la détection de Salmonella dans la filière avicole française

Détection précoce de Salmonella dans les volailles françaises : un système d’alerte s’appuyant sur l’apprentissage automatique face au changement climatique

Introduction

La prévalence de la salmonellose, maladie transmissible par la chaîne alimentaire, constitue un enjeu majeur de santé publique. Les filières avicoles françaises représentent une source importante d’infection par Salmonella, dont la propagation se trouve amplifiée par les fluctuations climatiques. L’évolution des facteurs environnementaux liés au climat complexifie la détection et la prévention de cette bactérie. L’avènement des techniques d’apprentissage automatique offre aujourd’hui de nouvelles solutions pour anticiper les épisodes de contamination. Cet article présente le développement et la validation d’un système d’alerte précoce basé sur le machine learning, spécifiquement adapté à la surveillance de Salmonella en production avicole face au changement climatique.

Analyse des risques climatiques sur la contamination avicole à Salmonella

Les variables climatiques – notamment la température, l’humidité relative et les précipitations – influencent la survie et la circulation de Salmonella dans les exploitations avicoles. Les projections des modèles climatiques prévoient l’accroissement de phénomènes extrêmes et d’oscillations saisonnières marquées en France, affectant la prolifération bactérienne. Ces modifications environnementales rendent nécessaire l’adaptation des outils de surveillance, afin de maintenir un niveau optimal de sécurité alimentaire.

Conception du système d’alerte précoce

Le dispositif élaboré combine l’analyse de données environnementales, épidémiologiques et de pratiques d’élevage avec le déploiement d’algorithmes d’apprentissage supervisé. Le modèle s’appuie sur un ensemble d’indicateurs :

  • Données de températures et d’humidité recueillies localement
  • Surveillance des précipitations et anomalies météorologiques saisonnières
  • Statistiques d’incidence des cas positifs à Salmonella dans diverses régions
  • Pratiques de gestion de l’élevage, rotations et assainissements

Ces variables alimentent un réseau de prédiction susceptible de détecter précocement les pics de risque de contamination.

Sélection des méthodes de machine learning

L’étude a évalué plusieurs techniques de classification, notamment les forêts aléatoires (random forests), les réseaux de neurones artificiels et les machines à vecteurs de support (SVM). Les performances ont été mesurées via la sensibilité, la spécificité et l’aire sous la courbe ROC. La robustesse du système repose sur l’intégration croisée de ces modèles, permettant ainsi une adaptation dynamique aux données en constante évolution.

Validation et résultats du modèle

L’application du système à l’échelle nationale a révélé une capacité de détection accrue des épisodes d’incidence élevée de Salmonella, en particulier pendant les vagues de chaleur ou après des épisodes de fortes pluies. Les taux de faux positifs ont été minimisés grâce à l’intégration des paramètres de gestion agricole, renforçant la fiabilité de l’alerte. En exploitant des données sur plusieurs années, le modèle a démontré une aptitude à s’ajuster aux tendances saisonnières émergentes, s’alignant ainsi sur l’objectif d’anticipation associé au réchauffement climatique.

Impact sur la gestion du risque avicole

L’adoption de ce système permet aux éleveurs et autorités de santé publique de moduler rapidement leurs interventions préventives – telles que le renforcement des mesures d’hygiène, la modulation des flux d’animaux ou le contrôle ciblé des lots. Il contribue également à la priorisation des analyses en laboratoire, optimisant l’allocation des ressources.

Perspectives et optimisation future

L’approche fondée sur l’apprentissage automatique est évolutive : l’ajout de nouvelles sources de données, telles que les images satellite pour la surveillance des conditions de sol ou les indicateurs de stress environnemental, pourrait affiner la précision. Par ailleurs, l’intégration de l’intelligence artificielle au sein des chaînes de production permet d’anticiper plus efficacement l’apparition de nouveaux profils de risque liés aux transitions climatiques.

Enjeux éthiques et limitations

La mise en œuvre d’un tel outil requiert un cadre de gestion des données respectueux des règles de confidentialité et de protection de la vie privée. Par ailleurs, si le système offre une capacité d’anticipation sans précédent, il ne saurait se substituer à l’expertise humaine pour l’interprétation des alertes et la mise en œuvre des mesures correctrices.

Conclusion

Le système d’alerte précoce basé sur l’apprentissage automatique représente une avancée significative dans la gestion proactive du risque Salmonella pour la filière avicole française. Il permet d’adapter la surveillance et la réponse sanitaire à l’évolution rapide des conditions climatiques, répondant ainsi aux impératifs de sécurité alimentaire et de résilience face au changement global.

Source : https://www.sciencedirect.com/science/article/pii/S0956713526004652?via=ihub

Apprentissage Automatique : Prédiction de la Croissance de Salmonella Enteritidis sur la Viande de Poulet Traitée par Eau Électrolysée

Modélisation par Apprentissage Automatique pour la Prédiction de la Croissance de Salmonella Enteritidis sur la Viande de Poulet avec de l'Eau Électrolysée

Introduction

L'utilisation de l'apprentissage automatique a révolutionné la microbiologie alimentaire. Cet article met en lumière l'application de modèles de machine learning pour prédire la croissance de Salmonella Enteritidis (S. Enteritidis) sur la viande de poulet, en particulier lorsqu'elle est traitée avec de l'eau électrolysée. Le contrôle microbien dans la viande de volaille étant crucial pour la sécurité alimentaire mondiale, l'amélioration des méthodes prédictives grâce aux outils d'intelligence artificielle offre de nouvelles perspectives en matière de prévention des risques sanitaires.

Contexte et Objectifs

La viande de poulet représente un terrain de croissance idéal pour les pathogènes alimentaires, notamment S. Enteritidis. L'électrolyse de l'eau, qui génère des solutions oxydantes, présente de puissantes propriétés antimicrobiennes. Ce travail vise à développer des modèles prédictifs fiables permettant d'estimer la croissance bactérienne dans des conditions variées d'entreposage et de traitement, optimisant ainsi les mesures de sécurité pour les industriels et les régulateurs.

Méthodologie

Préparation des échantillons et traitement

Des échantillons de viande de poulet ont été contaminés avec une souche spécifique de S. Enteritidis et traités par différentes concentrations d'eau électrolysée. Les paramètres suivants ont été évalués :

  • Températures de stockage diverses
  • Différents niveaux de pH
  • Concentrations variées de chlore libre dans l'eau électrolysée

Après traitement, la croissance bactérienne a été mesurée à intervalles réguliers, permettant la constitution d'un vaste jeu de données expérimentales.

Développement des modèles d'apprentissage automatique

Les jeux de données générés ont été utilisés pour entraîner et valider plusieurs modèles de machine learning, notamment :

  • Les réseaux de neurones artificiels (RNA)
  • Les arbres de décision
  • La régression non linéaire multivariée

L'entraînement des modèles s'est basé sur l'intégration des facteurs principaux (température, pH, chlore résiduel, temps d'incubation) pour une prédiction performante du taux de croissance de S. Enteritidis.

Validation des modèles

La performance prédictive a été évaluée grâce aux indicateurs classiques :

  • Coefficient de détermination (R²)
  • Erreur quadratique moyenne (RMSE)
  • Tests croisés de validation externe

L'objectif était d'atteindre la plus grande robustesse prédictive possible pour une utilisation fiable en situation réelle.

Résultats

Contribution des facteurs de croissance

L'analyse a démontré que la température reste le principal facteur déterminant la dynamique de croissance de S. Enteritidis. Le pH et la concentration en chlore libre, déterminés par le type d'eau électrolysée, influencent directement les taux d'inactivation bactérienne. Une synergie positive a été observée entre ces variables, permettant une meilleure répression de la croissance.

Performances des modèles

Parmi les modèles testés, le réseau de neurones artificiels a présenté la meilleure capacité de prédiction, atteignant un R² supérieur à 0,98 lors des tests de validation croisée. Les arbres de décision offrent une meilleure interprétabilité, mais une légère diminution de la performance prédictive. Les méthodes multivariées classiques restent pertinentes pour des situations où la simplicité et la rapidité d'exécution sont privilégies.

Visualisation des prédictions

Les sorties des modèles confirment la supériorité des traitements à haut niveau de chlore libre. Il a été observé que même à température modérée, l'activité antimicrobienne des solutions électrolysées ralentit significativement la croissance de S. Enteritidis au sein de la matrice carnée.

Implications et Applications Pratiques

L'intégration de l'apprentissage automatique dans la prédiction des risques de croissance bactérienne constitue une rupture méthodologique par rapport aux modèles cinétiques classiques. Les modèles élaborés ici facilitent la prise de décision en matière de contrôle hygiénique pour l'industrie agroalimentaire, permettant notamment :

  • L'optimisation des protocoles de désinfection des surfaces et des produits
  • La prédiction rapide du risque sanitaire selon des conditions de traitement réelles
  • L’anticipation des risques microbiens en fonction de la chaîne du froid et des procédés de transformation

Ces outils prédictifs offrent ainsi un avantage concurrentiel et assurent une meilleure protection du consommateur.

Perspectives de Développement

Les résultats mettent en avant la nécessité d’intégrer des données environnementales supplémentaires, comme l'humidité ou la charge microbienne initiale, pour affiner la précision des modèles. À terme, une modélisation intégrée des différents pathogènes et des paramètres multiples permettrait de bâtir des plateformes décisionnelles automatisées à destination des professionnels du secteur avicole.

Conclusion

La modélisation par apprentissage automatique, appliquée à la croissance bactérienne sur la viande de poulet traitée par eau électrolysée, s'avère être un outil de prédiction rapide et fiable. Elle représente un enjeu majeur pour la modernisation du contrôle sanitaire en industrie alimentaire, contribuant ainsi à la réduction des risques d’intoxication et à la sécurisation de la chaîne alimentaire.

Source : https://www.sciencedirect.com/science/article/pii/S0032579126011405

Prédiction avancée de la croissance de Bacillus cereus par apprentissage automatique et modélisation mathématique

Prédiction par apprentissage automatique de la croissance de Bacillus cereus à l’aide de modèles mathématiques

Introduction

La maîtrise de la croissance bactérienne, notamment celle de Bacillus cereus, est un enjeu crucial dans la sécurité alimentaire. L’émergence de l’apprentissage automatique (machine learning, ML) a permis de développer des approches prédictives avancées pour modéliser la prolifération de ces microorganismes. Dans cet article, nous explorons l’application de modèles mathématiques couplés à des techniques d’apprentissage automatique afin d’estimer avec précision la croissance de Bacillus cereus, agent pathogène fréquemment lié aux intoxications alimentaires.

Cadre et Méthodologie

Acquisition et Préparation des Données

Des cultures de Bacillus cereus ont été menées sous diverses conditions environnementales : température, pH, concentration en NaCl et teneur en eau. Ces données expérimentales servent de base à l’entraînement des algorithmes de machine learning.

Modélisation mathématique

Deux approches de modélisation ont été explorées et comparées :

  • Modèles classiques linéaires et non linéaires : Incluant le modèle de croissance logistique et le modèle de Gompertz.
  • Réseaux de neurones artificiels (RNA) : Techniques d’intelligence artificielle permettant de capter des relations complexes entre variables environnementales et croissance bactérienne.

Les performances respectives de ces modèles sont évaluées au moyen de métriques statistiques rigoureuses (MSE, R²).

Modèles mathématiques traditionnels

La croissance bactérienne a été traditionnellement prédite à l’aide de modèles structurés comme le modèle logistique ou celui de Gompertz, formulant la dynamique de croissance selon des équations différentielles. Ces modèles prennent en compte les phases de latence, d’exponentielle et stationnaire, mais peinent face à la variabilité des conditions environnementales multiples.

Avantages :

  • Simplicité
  • Facilité d’interprétation des paramètres biologiques

Limites :

  • Forte dépendance à la structure du modèle
  • Moindre précision lorsque les systèmes deviennent complexes

Apprentissage Automatique et Réseaux de Neurones

L’étude démontre qu’un réseau de neurones à propagation avant, entraîné par rétropropagation, surpasse de manière sensible les modèles mathématiques classiques en matière de prédiction de la croissance bactérienne. L’approche RNA intègre de façon flexible les variations multi-environnementales sans nécessiter de présupposés stricts sur la forme de la fonction de croissance.

Structure et entraînement du modèle

  • Entrées : Variables environnementales (température, pH, etc.)
  • Sortie : Densité cellulaire de Bacillus cereus (UFC/mL)
  • Entraînement : Division des jeux de données en sous-ensembles d’apprentissage et de validation
  • Optimisation : Algorithme de rétropropagation du gradient pour minimiser l’erreur prédictive

Performance comparative

Les résultats illustrent une nette amélioration du coefficient de détermination R² (proche de 0,99 pour les RNA contre 0,92 à 0,96 pour les autres modèles) et une réduction significative de l’erreur quadratique moyenne (MSE).

Discussion et Application Industrielle

Les réseaux de neurones offrent une capacité d’adaptation remarquable, capturant non seulement la croissance moyenne de Bacillus cereus, mais aussi les effets complexes d’interactions entre facteurs physico-chimiques. Cette robustesse prédictive fait du ML un outil particulièrement pertinent pour l’industrie agroalimentaire souhaitant anticiper précisément les risques microbiologiques.

L’intégration de ces modèles dans les outils de gestion de la sécurité alimentaire permettrait d’optimiser les processus de conservation, de prédire les dates limites de consommation ou encore de concevoir des formulations plus sûres.

Limites et perspectives

Si la supériorité technique du ML est démontrée, la généralisation de ces modèles dépend de la disponibilité de jeux de données robustes et variés. L’entraînement exige également une phase de validation approfondie pour garantir la transférabilité aux bassins industriels d’intérêt.

À l’avenir, il conviendrait d’explorer des architectures de réseaux plus complexes (réseaux profonds/convolutifs), de combiner plusieurs types de modèles (ensemblistes) et d’intégrer ces outils au sein de plateformes de pilotage industriel en temps réel.

Conclusion

L’apprentissage automatique appliqué à la prévision de la croissance de Bacillus cereus ouvre la voie à une maîtrise accrue des risques en industrie agroalimentaire. En dépassant les limites des modèles mathématiques classiques, il permet une meilleure anticipation des comportements bactériens et une optimisation plus fine des stratégies de gestion de la sécurité des aliments.

Source : https://www.sciencedirect.com/science/article/abs/pii/S0168160526002825?dgcid=rss_sd_all

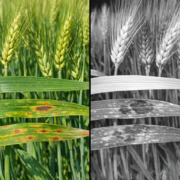
Détection et Classification Précoces des Maladies de l’Orge par Signatures Hyperspectrales VNIR et IA

Signatures Hyperspectrales VNIR et Apprentissage Automatique : Détection Précoce et Classification des Maladies de l'Orge

Introduction

L'orge (
Hordeum vulgare
) occupe une place centrale dans l'agriculture mondiale, avec des millions d'hectares cultivés notamment en Europe, en Amérique et en Asie. Sa vulnérabilité à diverses maladies fongiques et bactériennes représente une menace majeure pour la productivité. La détection rapide et précise de ces pathologies s'avère donc essentielle pour minimiser les pertes et optimiser la gestion phytosanitaire.

Cet article détaille comment la spectroscopie d'imagerie hyperspectrale dans le proche infrarouge visible (VNIR) combinée à l'apprentissage automatique révolutionne l'identification précoce des maladies de l'orge. Grâce à une analyse rigoureuse des signatures hyperspectrales, il devient possible de discriminer précocement les tissus sains et infectés, ouvrant la voie à un diagnostic non destructif à haut débit.

Les Fondements de l'Imagerie Hyperspectrale VNIR

Qu’est-ce que la VNIR ?

La VNIR (Visible and Near Infrared: 400-1000 nm) utilise la réflexion lumineuse des feuilles pour en déduire leur état physiologique. Les capteurs hyperspectraux enregistrent simultanément des centaines de bandes spectrales continues, offrant ainsi un profil détaillé de la lumière réfléchie par la plante.

Réponses Spectrales aux Maladies

Les infections provoquent des altérations structurelles et biochimiques de la feuille : accumulation de chlorophylle, modification de l’eau intracellulaire, détérioration des parois cellulaires. Ces changements sont directement détectables à certaines longueurs d’onde, produisant des "empreintes" spectrales typiques pour chaque maladie.

Méthodologie : Acquisition et Traitement des Données

Le protocole commence par la collecte d’imageries hyperspectrales sur différentes variétés d’orge, indemnes ou infectées naturellement ou expérimentalement par des agents pathogènes courants tels que Blumeria graminis (oïdium), Puccinia hordei (rouille brune) et Rhynchosporium secalis (rincosporiose). Les échantillons sont observés à différents stades après l’inoculation pour capturer l'évolution spectrale des symptômes.

Après acquisition, chaque pixel d’image représente un spectre unique analysé par diverses méthodes statistiques. Pour réduire la dimensionnalité et se concentrer sur les longueurs d’onde discriminantes, des techniques telles que l’analyse en composantes principales (PCA) et la sélection de variables sont appliquées.

Exploitation de l’Apprentissage Automatique

Des modèles supervisés, principalement des machines à vecteurs de support (SVM), sont entraînés avec des échantillons étiquetés. L’entraînement consiste à fournir au modèle un sous-ensemble de spectres connus pour chacun des quatre états : sain, oïdium, rouille brune et rinchosporiose.

Le reste des données constitue un jeu d’évaluation indépendant pour tester la robustesse et la précision du modèle. Les métriques employées pour évaluer la performance comprennent l’exactitude globale, la sensibilité, la spécificité et l’aire sous la courbe ROC (AUC).

Résultats : Différenciation Précise des Maladies de l’Orge

L’analyse multi-variée révèle que certaines plages spectrales, notamment entre 490–530 nm et 730–780 nm, sont nettement affectées par les maladies, permettant de distinguer les tissus infectés avec une précision supérieure à 95%. La SVM s’avère particulièrement performante, surpassant d’autres techniques comme les arbres décisionnels ou les forêts aléatoires pour ce jeu de données VNIR.

Les matrices de confusion confirment une faible occurrence de faux positifs et de faux négatifs, démontrant la fiabilité du diagnostic précoce, même à des stades asymptomatiques où les signes visuels sont absents.

Applications Pratiques et Bénéfices Agronomiques

La capacité à identifier les maladies avant l’apparition des symptômes visibles bouleverse la gestion moderne des cultures. Intégrés à des drones ou des stations automatisées, ces outils permettent une surveillance rapide de vastes surfaces, optimisant ainsi l’application ciblée des traitements et la sélection variétale plus résistante.

Les implications économiques et écologiques sont significatives : réduction des traitements prophylactiques inutiles, limitation de la dissémination des pathogènes, et amélioration du rendement.

Limites, Perspectives et Développements Futurs

Certaines nuances restent à perfectionner, notamment pour différencier des stress abiotiques (chaleur, carence) aux symptômes similaires. La généralisation des modèles à différentes régions agro-climatiques requiert une calibration locale. Les travaux futurs impliqueront le raffinement des algorithmes d’apprentissage profond et des analyses croisées multi-capteurs (VNIR, SWIR, thermique).

Conclusion

L’intégration de signatures hyperspectrales VNIR et de l’intelligence artificielle dans la phytopathologie de l’orge redéfinit les standards du diagnostic agricole. Cette technologie, en conjuguant rapidité, non-invasivité et précision, s’impose comme un pilier de l’agriculture de précision, garantissant un avenir plus résilient face aux challenges phytosanitaires majeurs.

Source : https://www.mdpi.com/2223-7747/15/12/1854

Apprentissage automatique basé sur le WGS : Révolution dans l’identification des dangers des pathogènes alimentaires

Avancées récentes de l'apprentissage automatique basé sur le WGS pour l'identification des dangers liés aux pathogènes d'origine alimentaire

Introduction

Ces dernières années, l'intégration du séquençage du génome complet (WGS, Whole Genome Sequencing) dans la surveillance et l'analyse des agents pathogènes d'origine alimentaire a transformé la façon dont nous identifions, caractérisons et maîtrisons les risques microbiologiques. Parallèlement, l'apprentissage automatique (machine learning, ML) a largement contribué à l'essor de méthodes prédictives et à la valorisation des données génomiques massives produites par le WGS. Cette synergie offre de nouveaux outils puissants pour l'identification des dangers, la traçabilité des agents infectieux et la gestion proactive de la sécurité alimentaire.

WGS et sécurité alimentaire : fondements et évolutions

Le séquençage du génome complet permet une évocation globale du code génétique des micro-organismes, fournissant un vaste ensemble de données pour l'analyse épidémiologique et la surveillance des pathogènes. Contrairement aux méthodes traditionnelles basées sur des marqueurs génétiques spécifiques ou des tests phénotypiques, le WGS donne accès à l'ensemble du patrimoine génétique des souches analysées.

Cette approche a permis d'améliorer la résolution dans l'identification des épisodes de contamination alimentaire, en distinguant précisément des isolats proches et en retraçant la source d'une infection avec une exactitude inégalée. L'intégration du WGS dans les réseaux mondiaux de surveillance a donc renforcé la capacité à intervenir rapidement et efficacement lors de crises sanitaires.

Apprentissage automatique : concepts et applications en génomique alimentaire

L'apprentissage automatique regroupe des méthodes computationnelles données pour détecter des motifs, établir des classifications ou faire des prédictions à partir de larges volumes d'information. Appliquée aux données WGS, cette technologie permet d'automatiser et d'accélérer le traitement de données génétiques complexes, facilitant ainsi la détection ciblée de gènes de virulence, de résistances aux antibiotiques ou d'autres marqueurs d'intérêt.

Méthodes employées

  • Apprentissage supervisé : utilisé pour catégoriser les isolats en fonction de leur potentiel pathogène ou de leur appartenance à des clones épidémiques. L’algorithme s'entraîne à partir d’ensembles de données annotées, puis applique cette expérience à de nouveaux échantillons.
  • Apprentissage non supervisé : utile pour découvrir de nouveaux groupements, tendances ou variants pathogènes inconnus sans données d'entrée catégorisées au préalable.
  • Réseaux de neurones profonds : technologie de pointe capable de traiter la complexité des relations entre des milliers de variables génomiques simultanément, adaptée à la prédiction fine des propriétés pathogènes.

Avantages de l’IA et du ML en génomique alimentaire

  • Précision accrue dans la prédiction de la virulence et de la résistance antibiotique des souches pathogènes.
  • Automatisation du dépistage à grande échelle, avec rapidité et reproductibilité, favorisant la gestion dynamique des alertes sanitaires.
  • Adaptabilité et évolutivité, avec la possibilité pour les modèles d'intégrer continuellement de nouvelles données et de s'améliorer en continu.

Applications pratiques et cas d’usage

Surveillance épidémiologique

La combinaison WGS—apprentissage automatique permet le suivi évolutif des agents pathogènes, la prévention des épidémies et l’identification rapide des souches sources durant les flambées d’infections (ex : Salmonella, Listeria, Escherichia coli).

Prédiction fonctionnelle et résistance aux antimicrobiens

Grâce à l'analyse d’ensemble des gènes, les modèles peuvent, sans intervention humaine massive, anticiper la présence de facteurs de virulence ou de gènes de résistance, déterminants pour la prise de décision en santé publique.

Optimisation des processus de traçabilité

L’IA appliquée aux données WGS facilite la reconstitution des trajets épidémiologiques dans les chaînes alimentaires, renforçant l’efficacité des rappels de produits et la prévention des risques récurrents.

Limitations, défis et perspectives

Problématiques de standardisation des données

La multiplicité des plateformes de séquençage et des formats crée des défis pour harmoniser et intégrer les ensembles de données utilisés pour l'entraînement et le test des modèles d'apprentissage.

Besoin en expertise multidisciplinaire

La réussite de l'application conjointe du WGS et du ML dépend de la présence de compétences croisées en biologie moléculaire, bio-informatique et intelligence artificielle, favorisant une interprétation fiable des résultats.

Questions éthiques et légales

La gestion des données génétiques pose des enjeux autour de la confidentialité, de la sécurité et de la gouvernance, notamment lors du partage d’informations au niveau international.

Perspectives d'évolution

La progression rapide des techniques d’apprentissage profond, la constitution de bases de données publiques massives et le déploiement de plateformes collaboratives en ligne ouvrent la voie à une utilisation toujours plus fine et performante des modèles prédictifs dans la lutte contre les pathogènes alimentaires.

Conclusion

L’union du séquençage du génome complet et de l’apprentissage automatique crée une révolution méthodologique dans la détection, la cartographie et la prévention des risques liés aux agents pathogènes alimentaires. Les perspectives sont vastes pour une sécurisation proactive des chaînes alimentaires, à condition de surmonter les défis techniques et éthiques associés à l’exploitation des données génomiques et à l'automatisation croissante.

Source : https://www.sciencedirect.com/science/article/abs/pii/S2214799326000548