Archive d’étiquettes pour : deep learning

L’intelligence artificielle au service de la détection des risques alimentaires

L’intelligence artificielle au service de la détection des risques alimentaires

La sécurité sanitaire des aliments repose sur la capacité à identifier rapidement les contaminants, les falsifications et les défauts susceptibles de présenter un danger pour les consommateurs. Les méthodes d’analyse traditionnelles restent indispensables, mais elles peuvent être longues, coûteuses et parfois destructives. Dans ce contexte, l’association des technologies spectrales et de l’apprentissage profond ouvre de nouvelles perspectives pour surveiller la qualité des aliments de manière plus rapide et automatisée.

Des technologies spectrales pour analyser les aliments

Les techniques spectrales exploitent la manière dont un aliment absorbe, réfléchit ou émet la lumière. Selon la technologie utilisée, l’analyse peut s’appuyer sur différentes régions du spectre électromagnétique, notamment le visible, le proche infrarouge, l’infrarouge moyen ou encore la fluorescence.

Ces méthodes permettent d’obtenir une signature spectrale caractéristique d’un produit. Celle-ci peut ensuite être utilisée pour repérer des variations liées à sa composition, à son état de conservation ou à la présence éventuelle d’un danger. L’un de leurs principaux atouts réside dans leur caractère rapide et non destructif, particulièrement intéressant pour les contrôles en laboratoire, dans les chaînes de production ou directement sur le terrain.

Le rôle du deep learning

Les données spectrales sont souvent complexes et difficiles à interpréter avec des modèles classiques. Elles peuvent contenir un grand nombre de variables, des signaux superposés et des variations liées à l’origine, à la maturité ou aux conditions de stockage des aliments.

Les algorithmes de deep learning, notamment les réseaux neuronaux convolutifs et les architectures capables de traiter des données multidimensionnelles, peuvent apprendre automatiquement les caractéristiques les plus pertinentes. Une fois entraînés sur des jeux de données suffisamment représentatifs, ils peuvent contribuer à :

  • détecter la présence de contaminants ;
  • identifier des produits frelatés ou mal étiquetés ;
  • distinguer différents niveaux de qualité ou de fraîcheur ;
  • reconnaître des anomalies invisibles à l’œil nu ;
  • estimer certains paramètres liés à la composition des aliments ;
  • accélérer le tri et le contrôle des lots.

Une surveillance plus large des dangers alimentaires

L’intégration de l’intelligence artificielle aux outils spectraux peut concerner plusieurs catégories de risques. Les systèmes étudiés peuvent notamment être appliqués à la détection de contaminants chimiques, de résidus, de toxines, d’allergènes ou de substances étrangères. Ils peuvent également contribuer à repérer certaines altérations microbiologiques, à condition que les signatures mesurées soient suffisamment discriminantes et que les données d’apprentissage soient adaptées.

Cette approche ne se limite pas à la détection d’un danger précis. Elle peut aussi aider à établir une cartographie de la qualité d’un produit, à comparer différents échantillons ou à surveiller l’évolution d’un aliment au cours de son stockage.

Des applications de la production au contrôle réglementaire

Sur une ligne de fabrication, l’analyse spectrale couplée à un modèle d’intelligence artificielle pourrait permettre un contrôle quasi instantané des matières premières et des produits finis. Les lots présentant un profil inhabituel pourraient être isolés pour une analyse complémentaire.

Dans les laboratoires, ces outils peuvent servir de méthodes de dépistage rapide avant la mise en œuvre d’analyses de référence plus longues. Ils peuvent également soutenir les inspections, le contrôle des produits importés et la vérification de l’authenticité des denrées alimentaires.

La miniaturisation des capteurs et le développement de solutions portables renforcent encore ce potentiel. À terme, certaines analyses pourraient être réalisées avec des équipements compacts connectés à des logiciels capables de fournir une première interprétation en quelques secondes.

Les limites à surmonter

Malgré leurs perspectives, ces technologies ne sont pas automatiquement fiables dans toutes les situations. La qualité des prédictions dépend fortement des données utilisées pour entraîner les modèles. Un jeu de données trop limité, déséquilibré ou peu représentatif peut entraîner des erreurs lorsque l’algorithme est confronté à de nouveaux produits, à d’autres variétés ou à des conditions différentes.

Plusieurs défis restent donc importants :

  • constituer des bases de données diversifiées et correctement annotées ;
  • harmoniser les protocoles d’acquisition des données spectrales ;
  • réduire l’influence des facteurs externes, comme l’humidité, la température ou l’emballage ;
  • améliorer l’interprétabilité des modèles de deep learning ;
  • valider les performances sur des échantillons réels et à grande échelle ;
  • garantir la compatibilité avec les normes et les exigences réglementaires.

La question de l’explicabilité est particulièrement importante dans le secteur alimentaire. Les professionnels doivent pouvoir comprendre pourquoi un échantillon a été classé comme suspect et disposer d’une méthode de confirmation reconnue.

Vers une sécurité alimentaire plus prédictive

La combinaison des technologies spectrales et du deep learning pourrait faire évoluer les contrôles alimentaires vers une surveillance plus continue, plus rapide et davantage fondée sur les données. Au lieu de se limiter à des analyses ponctuelles, les entreprises pourraient suivre la qualité des produits tout au long de la chaîne d’approvisionnement et intervenir plus tôt en cas d’anomalie.

Ces outils ne remplacent toutefois pas les méthodes analytiques de référence ni l’expertise des professionnels. Ils ont plutôt vocation à les compléter en facilitant le dépistage, en réduisant les délais et en orientant les analyses approfondies vers les échantillons les plus à risque.

L’enjeu des prochaines années sera de transformer les prototypes et les modèles expérimentaux en solutions robustes, traçables et simples à intégrer dans les environnements industriels. Une fois ces conditions réunies, l’intelligence artificielle pourrait devenir un élément central des stratégies modernes de prévention des dangers alimentaires.
Tri intelligent des tubercules de pomme de terre et des impuretés minérales via deep learning : développement et évaluation d’un système automatisé

Tri intelligent des tubercules de pomme de terre et impuretés minérales par deep learning : développement d’un système innovant et évaluation

Introduction

La filière agroalimentaire accorde une importance cruciale à la qualité de ses produits, en particulier dans le traitement post-récolte des pommes de terre. Un tri fiable permettant de distinguer efficacement les tubercules des impuretés minérales tel que pierres, mottes ou autres débris s’avère indispensable tant pour la sécurité alimentaire que pour l’optimisation des chaînes industrielles. Récemment, le recours à l’intelligence artificielle, et notamment au deep learning, a ouvert la voie à de nouveaux dispositifs de tri automatique haute performance.

Cet article dévoile la conception, la mise en œuvre et l’évaluation d’un système intelligent de tri automatisé s’appuyant sur des algorithmes de deep learning pour séparer les pommes de terre des impuretés minérales. Il met en lumière les enjeux techniques, les choix méthodologiques et les résultats obtenus à travers des expérimentations rigoureuses.

Développement du système de tri automatique

Architecture matérielle et logicielle

Le système développé comporte plusieurs modules interconnectés :

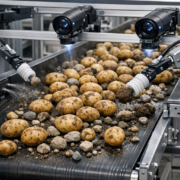
  • Un convoyeur motorisé assurant l’acheminement et la dispersion uniforme du flux mélangé (tubercules/impuretés).
  • Un module d’acquisition d’images équipé de caméras industrielles à haute résolution, capturant les lots en temps réel.
  • Une unité de traitement embarquant des algorithmes de deep learning pré-entraînés spécialisés dans la reconnaissance et la classification d’objets agroalimentaires.
  • Des actionneurs mécaniques assurant la séparation physique des éléments reconnus entre tubercules triés et déchets minéraux.

Traitement numérique et algorithmes de classification

Le cœur du dispositif repose sur l’entraînement de réseaux de neurones convolutifs (CNN) profonds, structurés autour d’une architecture de type ResNet-50 pour l’extraction de caractéristiques visuelles complexes. Ce modèle a été optimisé sur une base de données de milliers d’images annotées, couvrant l’ensemble des variations de morphologie, de texture et de couleur propres aux pommes de terre et aux diverses impuretés minérales.

Un pipeline de prétraitement implique :

  • Correction des variations d’éclairage,
  • Normalisation des pixels,
  • Suppression du bruit visuel.

Cela permet d’alimenter le modèle en entrées homogènes, améliorant sensiblement la robustesse de la classification.

Évaluation expérimentale du système

Base de données et protocole d'expérimentation

Pour évaluer le système, une vaste collection d’échantillons a été constituée, comprenant un panel représentatif de tubercules et de différentes catégories d’impuretés (blocs de sol, pierres naturelles, morceaux de bois, etc.).
La performance du dispositif a été analysée selon plusieurs métriques :

  • Taux de reconnaissance (accuracy) pour chaque type d’objet,
  • Précision de la séparation (souvent mesurée par la F1-score et l’IoU),
  • Rapidité de traitement par lot,
  • Résilience en conditions industrielles réelles (environnement poussiéreux, variations de luminosité, vitesse élevée du tapis).

Résultats obtenus et discussion

Les tests ont mis en évidence une capacité de détection remarquable, avec une précision globale dépassant 98% pour la distinction pomme de terre/impuretés, toutes catégories confondues. Le système démontre une grande stabilité opérationnelle, minimisant aussi bien les faux positifs (pommes de terre écartées à tort) que les faux négatifs (impuretés non éliminées).

La rapidité du dispositif (jusqu’à 30 images par seconde en temps réel) rend l’application parfaitement compatible avec les cadences industrielles modernes. Par ailleurs, la polyvalence du modèle permet d’adapter la solution à d’autres types d’impuretés ou de produits agricoles moyennant une phase de ré-entraînement supervisé.

Avantages et perspectives d’application

Bénéfices industriels

Ce système assure :

  • Une amélioration significative de la qualité des lots,
  • Une réduction des coûts liés au tri manuel,
  • Une sécurité sanitaire accrue grâce à un tri exhaustif,
  • Une optimisation des processus industriels avec moins de pertes et d’arrêts non planifiés.

Prolongements techniques

Les auteurs soulignent le potentiel du deep learning pour l’automatisation avancée dans l’agroalimentaire. Déploiements futurs envisagent :

  • Des modèles multi-classes capables de différencier plusieurs types de défauts et objets,
  • L'intégration de la vision hyperspectrale pour mieux discriminer les matières,
  • L’exploitation de l’analyse en temps réel pour le pilotage automatique des lignes de tri.

Conclusion

Le tri intelligent des pommes de terre et impuretés minérales par deep learning offre une avancée déterminante pour l’industrie agroalimentaire, associant précision, fiabilité et flexibilité opérationnelle. Ce système, validé expérimentalement, pose les bases de nouvelles générations de solutions automatisées portées par l’intelligence artificielle dans l’agriculture connectée.

Source : https://www.mdpi.com/2304-8158/15/12/2070

Détection rapide des pathogènes alimentaires : biocapteur à fluorescence amplifié par billes de fer et deep learning

Un biocapteur à fluorescence amplifié par microgouttelettes et billes de fer : détection rapide et intelligente des pathogènes alimentaires

Introduction

La contamination alimentaire par des agents pathogènes représente un défi critique pour la sécurité alimentaire mondiale. Les méthodes conventionnelles de détection s’avèrent souvent longues, peu sensibles, ou nécessitent des laboratoires spécialisés. Face à cette urgence, l’ingénierie de biocapteurs innovants utilisant la fluorescence, les microgouttelettes, et l’intelligence artificielle ouvre de nouvelles perspectives pour la surveillance en temps réel des pathogènes.

Avancées technologiques pour la détection des agents pathogènes alimentaires

L'approche biosensorielle : Définitions et enjeux

Un biocapteur à fluorescence associe un élément de reconnaissance biologique—ici des anticorps spécifiques de pathogènes—à une transduction du signal par fluorescence, offrant ainsi précision et rapidité. Couplée à l’utilisation de billes de fer magnétiques et de microgouttelettes, cette approche permet d’isoler et de concentrer les bactéries d’intérêt tout en minimisant les bruits de fond liés à la matrice alimentaire.

Rôle des billes de fer et des microgouttelettes

  • Billes de fer magnétiques : Utilisées pour extraire et concentrer spécifiquement les pathogènes cibles (par exemple E. coli, Salmonella, Listeria), elles facilitent un enrichissement local élevé, optimisant la détection.
  • Microgouttelettes : Grâce à la microfluidique, l’échantillon est fragmenté en microgouttelettes, permettant la manipulation individuelle de milliers d’analytes en parallèle, accroissant la sensibilité du biocapteur et réduisant la probabilité de faux négatifs.

Principe de fonctionnement du biocapteur à fluorescence

Après immobilisation des anticorps sur les billes de fer, l’échantillon contenant les bactéries est mélangé à des sondes fluorescentes spécifiques qui signalent la présence de pathogènes via une émission lumineuse mesurable. Chaque microgouttelette agit comme un réacteur individuel, où la réaction de détection se produit de manière indépendante, garantissant ainsi la spécificité et la robustesse des résultats.

Intégration du Deep Learning dans l’analyse des signaux fluorescents

L’énorme volume de données générées par l’analyse simultanée de milliers de microgouttelettes est analysé grâce à des algorithmes d’apprentissage profond (deep learning).

  • Reconnaissance intelligente des signaux : Les modèles trainés reconnaissent instantanément les profils de fluorescence caractéristiques des différents pathogènes.
  • Réduction des erreurs et automatisation : L’intelligence artificielle permet de diminuer la subjectivité de l’interprétation, tout en accélérant le processus d’identification et en permettant une gestion à grande échelle.

Performances du biosenseur microfluidique augmenté

Sensibilité et limite de détection

Ce biocapteur innovant démontre une limite de détection particulièrement basse, permettant d’identifier des concentrations inferieures au seuil infectieux des pathogènes alimentaires. La synergie entre la capture magnétique, le confinement en microgouttes, et l’analyse algorithmique assure rapidité, spécificité et reproductibilité.

Temps d’analyse

L’ensemble de la procédure, de l’enrichissement à la lecture des résultats, se déroule en moins d’une heure, contrastant nettement avec la culture bactérienne classique qui peut demander plusieurs jours.

Spécificité et multiplexage

Le système peut être adapté pour détecter simultanément plusieurs types d’agents pathogènes grâce à l’utilisation de sondes à spectres fluorescents distincts. L’automatisation du traitement des images permet la classification et le comptage rapides de différentes souches bactériennes dans un même échantillon.

Applications et perspectives

  • Surveillance alimentaire : Adaptable aux chaînes de production, marchés ou restaurants, ce dispositif permet un contrôle sur site de la sécurité alimentaire.
  • Détection d’urgence en santé publique : Utilisable lors de contaminations massives ou d’alertes sanitaires pour endiguer la propagation rapide de pathogènes.
  • Recherche et développement : Plateforme précieuse pour l'étude de pathogènes émergents et le développement de stratégies de prévention innovantes.

Conclusion

Le biocapteur à fluorescence optimisé par microgouttelettes et billes de fer, renforcé par l’analyse intelligente, redéfinit la détection rapide des pathogènes alimentaires. Cette technologie conjugue microfluidique, magnétisme, et intelligence artificielle pour une surveillance efficace, précise et quasi-instantanée, offrant une solution d’avenir pour garantir la sécurité alimentaire à l’échelle globale.

Source : https://www.sciencedirect.com/science/article/abs/pii/S0026265X26024318?via%3Dihub

Plateforme MobileNetV2 efficace pour la détection des maladies des plantes sur appareils à ressources limitées

Plateforme MobileNetV2 Optimisée pour la Détection des Maladies des Plantes sur Appareils à Ressources Limitées

Introduction

La surveillance des maladies des plantes constitue un enjeu crucial pour l’agriculture moderne, jouant un rôle déterminant dans la prévention des pertes de récoltes et la garantie de la sécurité alimentaire. Tandis que la détection visuelle traditionnelle montrée ses limites face à l’augmentation de la productivité agricole et la réduction des effectifs de spécialistes, l’essor de solutions intelligentes basées sur le deep learning ouvre la voie à une nouvelle ère diagnostique. Cependant, les systèmes conventionnels d’apprentissage profond requièrent des ressources matérielles conséquentes, souvent inaccessibles pour les appareils mobiles ou les plateformes embarquées. C’est dans ce contexte que s’inscrit la présente étude, proposant un cadre efficace reposant sur MobileNetV2 pour la détection automatisée et rapide des maladies des plantes sur des dispositifs à capacités limitées.

Conception du Cadre MobileNetV2 Optimisé

Justification du Choix de MobileNetV2

MobileNetV2 s’appuie sur une architecture légère de réseaux de neurones convolutifs, spécialement conçue pour l’inférence sur des appareils dotés de ressources restreintes. Grâce à ses couches de convolution séparables en profondeur (depthwise separable convolutions) et à l’introduction de « linear bottlenecks » et « inverted residuals », elle minimise la complexité computationnelle tout en assurant des performances élevées pour la classification d’image.

Personnalisation du Modèle

La version adaptée de MobileNetV2 développée dans cette étude ajuste les hyperparamètres clés — profondeur, largeur des couches, nombre de classes — en vue d’équilibrer précision et vitesse d’inférence. L’approche inclut :

  • Pruning (élagage des poids) : élimination des poids redondants pour alléger le modèle sans nuire à la performance.
  • Quantification de poids : réduction de la taille des paramètres du modèle, passant du format flottant au format entier.
  • Optimisation pour inference temps réel : adaptation du pipeline pour assurer la détection de maladies directement sur des appareils mobiles, tablet PCs, ou capteurs connectés.

Méthodologie d’Acquisition et d’Augmentation des Données

Le jeu de données exploité combine plusieurs ensembles publics et des images collectées sur le terrain afin d’offrir une diversité conséquente en variétés de plantes et en types de pathologies (champignons, bactéries, carences, etc.). Pour pallier le déséquilibre inhérent à certaines classes et enrichir la robustesse du modèle, le pipeline utilise :

  • Transformation géométrique (rotation, inversion, recadrage)
  • Modification des couleurs et contrastes
  • Ajout de bruit gaussien
  • Occlusion partielle simulée

Cette stratégie d’augmentation améliore la capacité généralisatrice du modèle et son adaptation à la variabilité de conditions in situ.

Résultats Expérimentaux et Evaluation

Protocole de Test

Le cadre MobileNetV2 amélioré a été comparé à plusieurs réseaux de référence (VGG, ResNet, EfficientNet) sur la précision, la taille du modèle, le temps d’inférence et la consommation mémoire. Les tests sont effectués tant sur stations de travail que sur divers smartphones Android.

Performances Obtenues

  • Précision de classification : Le modèle atteint un taux de reconnaissance de 97,3% (moyenne sur 12 classes de maladies)
  • Latence d’inférence : Moins de 50 ms par image sur smartphone milieu de gamme
  • Empreinte mémoire : Taille de modèle réduite à 7 Mo après quantification et pruning
  • Compatibilité multiplateforme : Fonctionnement fluide sur Raspberry Pi, Arduino avec extension IA, téléphones Android, et iOS

L’étude note par ailleurs que l’efficacité de MobileNetV2 fait d’elle une architecture particulièrement adaptée à la télédétection dans des contextes contraints où connectivité et puissance de calcul sont limitées.

Déploiement Embarqué et Applications

Intégration Cloud-Edge

L’architecture supporte l’inférence décentralisée sur les appareils au plus près du terrain (edge computing), réduisant la nécessité de transmissions de données volumineuses vers le cloud et optimisant la réactivité du système.

Scénarios d’Utilisation

  • Application mobile pour agriculteurs : prise de photo et diagnostic instantané sur le terrain
  • Capteur intelligent à base d’IA : embarqué dans des systèmes de surveillance pour alerter en temps réel en cas de détection de maladie dans des serres ou exploitations agricoles
  • Support à la recherche agricole : étiquetage rapide de grands ensembles de données pour les chercheurs

Perspectives et Limites

Même si le cadre atteint de hautes performances sur les tâches de classification et détection, quelques restrictions subsistent, notamment la nécessité de jeux de données encore plus larges et diversifiés pour couvrir l’ensemble des espèces et maladies régionales. L’intégration future de modules d’explication (explainable AI) et de feedback utilisateur pourrait optimiser la confiance et l’adoption du système.

Conclusion

L’approche proposée démontre qu’il est possible de fusionner l’efficacité computationnelle de MobileNetV2 avec les exigences de l’agriculture numérique moderne. Ce cadre jette les bases d’un diagnostic phytosanitaire automatisé, précis et rapide, accessible aux agriculteurs et chercheurs, même dans les environnements techniques les plus contraints.

Source : https://www.mdpi.com/2079-9292/15/15/3343

Deep Learning pour la détection des maladies du caféier : Enjeux pour la traçabilité dans l’e-commerce agricole

Deep Learning et détection des maladies du caféier : Défis et perspectives pour la traçabilité de la qualité dans l’e-commerce agricole

Introduction

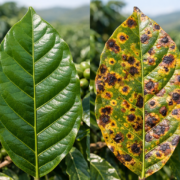
La culture du café, essentielle à l’économie mondiale et surtout cruciale pour de nombreux pays producteurs, fait face à des risques sanitaires majeurs dus aux maladies fongiques et bactériennes touchant les feuilles. Ces maladies compromettent aussi bien la quantité que la qualité de la récolte. L’émergence de l’e-commerce agricole, dont les plateformes numériques facilitent le commerce du café, accentue les besoins en traçabilité et en maintien de la qualité. L’intégration du deep learning dans la détection précoce des maladies du caféier représente une avancée techno-scientifique inédite, apportant de nouvelles réponses à ces défis complexes.

Les enjeux de la détection des maladies du caféier

La détection manuelle traditionnelle, longtemps pratiquée dans les plantations, se révèle chronophage, peu fiable et sensible à l’expertise humaine. Face à la variété des symptômes foliaires et aux conditions de culture mouvantes, la précision du diagnostic repose fortement sur la compétence de chaque observateur. Adoptant des modèles d’apprentissage profond, les chercheurs cherchent à automatiser ce processus, tendre vers l’universalité des diagnostics et fiabiliser la chaîne de valeur.

Maladies principales du caféier

  • Rouille (Hemileia vastatrix)
  • Cercosporiose (Cercospora coffeicola)
  • Taches bactériennes (Pseudomonas syringae)

La présence desdites maladies, mal maîtrisée, menace le rendement mais aussi la réputation qualitative des lots sur les marchés internationaux.

Fondements du Deep Learning appliqué à la phytopathologie

Le deep learning, sous-branche de l’intelligence artificielle, traite l’analyse d’images foliaires via des réseaux de neurones convolutifs (CNN) capables d’extraire caractéristiques visuelles complexes. Ces modèles vont au-delà du simple classement d’images en apprenant à identifier des motifs subtils, spécifiques à chaque pathologie. Les recherches actuelles privilégient des architectures telles que ResNet, VGG ou EfficientNet, connues pour leur robustesse statistique.

Étapes du pipeline d’apprentissage profond

  1. Collecte d’images de feuilles de caféier, annotées par des experts.
  2. Prétraitement des images (suppression du bruit, augmentation de données, correction colorimétrique).
  3. Entraînement du modèle CNN pour distinguer feuilles saines et malades.
  4. Validation et test sur un ensemble d’images inédites.

Limites actuelles et problématiques de généralisation

Malgré les progrès, plusieurs obstacles entravent la généralisation à grande échelle :

  • Variabilité environnementale : luminosité, arrière-plan, stade de la feuille altèrent la qualité des images.
  • Données annotées limitées : La constitution de bases d’images couvrant exhaustivement toutes les classes/variétés reste très coûteuse.
  • Overfitting : Les modèles surapprennent parfois les données disponibles sans capacité à s’adapter à de nouveaux cas.
  • Interprétabilité réduite : Les CNN agissent comme des « boîtes noires », rendant l’explication des résultats difficile pour les utilisateurs finaux.

Des techniques de régularisation, de transfert d’apprentissage et l’intégration de données issues de réseaux collaboratifs sont testées pour pallier ces limites.

Vers une traçabilité renforcée dans le secteur agricole via l’IA

La fiabilité de la détection automatisée s’inscrit au cœur des problématiques de traçabilité qui façonnent le marché du café en e-commerce. Permettre à chaque lot de bénéficier d’une certification numérique de son état phytosanitaire favorise l’instauration de nouvelles normes de transparence :

  • Intégration blockchain pour enregistrer, authentifier et tracer les diagnostics associés à chaque lot exporté.
  • Rapidité des contrôles sur les flux logistiques, limitant propagation et pertes de qualité.
  • Renforcement de la confiance entre producteurs, négociants et consommateurs finaux via un suivi dynamique basé sur l’IA.

Perspectives et recommandations pour l’implémentation pratique

L’industrialisation de ces solutions requiert des efforts coordonnés :

  • Élaboration de jeux de données multi-régionaux en collaboration avec les coopératives agricoles.
  • Déploiement de modèles légers pouvant être embarqués sur smartphones ou drones.
  • Formation des acteurs de terrain à l’usage des technologies de deep learning.
  • Collaboration interdisciplinaire pour l’adaptation des outils aux contraintes réelles des plantations.

Les réseaux de neurones doivent être continuellement réentraînés pour intégrer les mutations pathologiques émergentes et renforcer leur capacité de prédiction.

Conclusion

L’emploi du deep learning pour la détection anticipée et automatisée des maladies du caféier s’impose comme un levier d’excellence pour la traçabilité et la maîtrise de la qualité dans l’e-commerce agricole. Malgré des défis méthodologiques persistants – variabilité des données, manque de transparence des modèles, nécessité de bases d’images étoffées – l’intégration progressive de solutions IA dans la chaîne de production promet une transformation durable du secteur caféier. Le futur se dessine autour d’écosystèmes collaboratifs, associant agriculteurs, experts en données et acteurs de la supply chain pour une agriculture connectée, transparente et qualitative.

Source : https://www.mdpi.com/2077-0472/16/15/1664

Machine Learning et Deep Learning : défis et enjeux pour l’analyse des aliments

Enjeux et défis du Machine Learning et Deep Learning appliqués à l'analyse des aliments : synthèse et perspectives

Introduction à l'intelligence artificielle et aux sciences alimentaires

L'application du machine learning (ML) et du deep learning (DL) dans l'analyse des aliments s'impose aujourd'hui comme un levier incontournable pour moderniser et fiabiliser les procédés de contrôle qualitatif et quantitatif en agroalimentaire. Fortes d'une capacité inégalée à extraire des motifs complexes et à traiter de vastes volumes de données, ces technologies disruptives s'inscrivent au cœur de l'innovation, bouleversant les méthodes analytiques traditionnelles basées sur les approches statistiques classiques.

Méthodes analytiques : évolution vers l'intelligence artificielle

L'analyse des aliments faisait historiquement appel à des méthodes manuelles et destructives, lentes ou coûteuses. Désormais, la croissance des données issues de la spectroscopie, de l'imagerie hyperspectrale ou des capteurs intelligents impose des modèles prédictifs puissants et automatisés. Les réseaux neuronaux, support vector machines, arbres de décision et autres algorithmes avancés permettent une extraction automatisée de caractéristiques, facilitant ainsi la précision de l'identification, de la classification, voire de la quantification de nombreux paramètres alimentaires.

Exemples d'applications :

  • Détection de contaminants et d'adultération (par exemple, pesticides, mycotoxines, mélamine)
  • Analyse de la composition nutritionnelle et authentification géographique
  • Caractérisation des propriétés sensorielles (goût, couleur, texture)

Principales difficultés rencontrées

1. Qualité et quantité des données

L'un des obstacles majeurs reste l'accès à des jeux de données robustes, homogènes et largement annotés. Le manque de diversité, les déséquilibres de classe et l’absence de données de référence limitent la fiabilité des modèles, tandis que la variabilité extrême des matrices alimentaires ajoute une couche de complexité inutilisée dans de nombreux domaines technologiques.

2. Interprétabilité des modèles

Le deep learning, bien qu’extrêmement performant, est souvent considéré comme une "boîte noire" dont les résultats ne sont pas toujours explicables. Or, dans un secteur réglementé comme l’agroalimentaire, la traçabilité et l’explicabilité des résultats priment pour garantir la confiance des parties prenantes et des autorités de contrôle.

3. Portabilité et robustesse

L’apprentissage des modèles peut s’avérer spécifique à un équipement, une matrice ou un environnement donné, rendant leur transfert difficile d’un laboratoire à l’autre ou d’une production à l’autre. La robustesse face au bruit, aux variations saisonnières ou géographiques est une exigence impérative.

4. Coûts computationnels et choix d’architecture

L’entraînement de modèles complexes exige des ressources de calcul massives, parfois incompatibles avec les équipements embarqués trouvés en chaîne de production. Le choix et l'optimisation des architectures de réseaux nécessitent une expertise élevée, ce qui constitue un second défi.

Optimisation et bonnes pratiques en intelligence artificielle alimentaire

Prétraitement des données

Le prétraitement (normalisation, extraction de caractéristiques, nettoyage des données) conditionne fortement la performance des modèles. L’automatisation de cette étape par l’intégration de méthodes intelligentes telles que la réduction de dimensionnalité ou le feature extraction permet de renforcer la reproductibilité des analyses tout en réduisant la dépendance à l’expertise humaine.

Data augmentation et transfert de connaissances

La data augmentation – générant artificiellement de nouvelles observations à partir de petits échantillons – s'avère essentielle pour pallier le manque de données alimentaires, tandis que l’apprentissage par transfert tire parti de modèles préentraînés, accélérant l’adaptation à de nouvelles tâches ou matrices.

Gestion des biais et validation croisée

La correction des biais inhérents à la collecte des données s’impose, passant par une validation croisée rigoureuse et l’emploi de différentes métriques d’évaluation (accuracy, précision, rappel, F1-score, courbes ROC/AUC…). Les algorithmes explicatifs comme LIME ou SHAP deviennent essentiels pour comprendre les décisions du modèle.

Avancées récentes et perspectives

L'intégration simultanée de sources de données multiples (multi-omics, spectroscopie, vision, données sensorimétriques) ainsi que l’essor de l’apprentissage automatique auto-encadré (self-supervised learning) augurent une automatisation accrue et une détection de plus en plus fiable de la fraude, de la contamination ou de l’authenticité des aliments. Le développement de frameworks open source favorise la reproductibilité et le partage des modèles à grande échelle.

Vers une adoption industrielle généralisée

Les collaborations multidisciplinaires, la normalisation des protocoles et la création de bases de données publiques standardisées sont clés pour accélérer le déploiement de l’IA en alimentaire. Ce processus est consolidé par de nouveaux modèles hybrides (statistiques-deep learning) et l’essor du cloud computing, réduisant les coûts et assurant la sécurité des données.

Conclusion

L’utilisation du machine learning et du deep learning dans l’analyse alimentaire a le potentiel de transformer durablement le secteur en termes de rapidité, précision et prédictivité. Surmonter les défis liés à la gestion des données, à l’interprétation des résultats et à la robustesse des modèles doit rester une priorité. En multipliant les initiatives de partage des données et en investissant dans la recherche collaborative, le secteur alimentaire pourra pleinement bénéficier de la révolution de l’IA.

Source : https://www.sciencedirect.com/science/article/pii/S0021967326005054?dgcid=rss_sd_all

Détection rapide de la fraîcheur de la viande crue : IA et réseaux colorimétriques

Détection rapide de la fraîcheur de la viande crue : intelligence artificielle et réseaux colorimétriques

Introduction

La détection de la fraîcheur de la viande crue demeure un enjeu central pour la sécurité agroalimentaire et la satisfaction des consommateurs. Traditionnellement, le contrôle de la qualité des viandes repose sur des méthodes physico-chimiques ou microbiologiques, souvent coûteuses et chronophages. L’émergence de technologies innovantes, telles que les réseaux colorimétriques couplés à l’intelligence artificielle, ouvre la voie à une évaluation rapide, précise et non destructive de la fraîcheur des viandes.

Réseaux colorimétriques : principes et applications

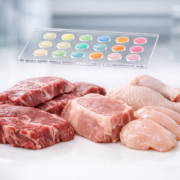
Les réseaux colorimétriques sont constitués de matrices de capteurs chimiquement réactifs capables de modifier leur couleur en réponse à des composés volatils libérés par la viande en décomposition. Placés à proximité de l’échantillon, ces réseaux réagissent de manière spécifique à différents processus de dégradation (tels que l’oxydation lipidique ou la prolifération microbienne), générant ainsi des motifs colorés uniques selon le degré de fraîcheur.

Les signaux colorimétriques sont acquis via des images numériques haute résolution, facilitant leur traitement automatisé. Cette approche offre une solution efficace, sans contact, adaptée au contrôle qualité en temps réel.

Intelligence artificielle : méthodes de traitement automatisé

Pour exploiter la richesse des données générées, l’intégration de techniques d’apprentissage profond (deep learning) s’avère essentielle. Les réseaux de neurones convolutifs (CNN) se distinguent notamment par leur capacité à extraire, apprendre et classifier les motifs complexes présents dans les images colorimétriques.

L’algorithme traite chaque image du réseau colorimétrique, détecte des caractéristiques spectrales implicites et attribue un niveau de fraîcheur prédictif. L’utilisation de grands ensembles de données pour l’entraînement permet d’optimiser la robustesse et la fiabilité du modèle prédictif.

Conception expérimentale et méthodologie

Échantillons

  • Viande de bœuf, porc et volaille, prélevée fraîche et stockée à température contrôlée.
  • Contrôle du vieillissement via des prélèvements échelonnés (0h, 24h, 48h, 72h, etc.).

Procédure de détection

  • Placement des réseaux colorimétriques au-dessus de la viande.
  • Acquisition des images à intervalles réguliers.
  • Analyse simultanée avec des méthodes de référence (microbiologie, TBARS, mesure du pH).

Traitement des données

  • Prétraitement numérique des images pour correction des artefacts.
  • Extraction de caractéristiques à partir des canaux RVB.
  • Entraînement du modèle CNN pour classifier les stades de fraîcheur.

Résultats et performances du système

Sensibilité et spécificité

L’approche basée sur le deep learning offre une discrimination précise entre la viande fraîche, moyennement fraîche et avariée. La précision de classification excède 90% pour la majorité des classes, avec une spécificité remarquable même pour des niveaux intermédiaires de dégradation.

Rapidité et automatisation

Le système d’analyse permet une évaluation quasi-instantanée (quelques secondes à quelques minutes), offrant ainsi une véritable solution temps réel pour les industriels et les distributeurs. Cela supprime le recours à des analyses laboratoires longues et coûteuses.

Comparaison avec les méthodes traditionnelles

Contrairement aux méthodes microbiologiques ou chimiques, les réseaux colorimétriques assistés par l’intelligence artificielle ne requièrent ni expertise technique pointue ni équipement complexe. Ils surpassent également les méthodes sensorielles (visuelles ou olfactives) en objectivité et répétabilité.

Limites et perspectives

Variabilité des matrices
La robustesse du système dépend de la diversité des échantillons utilisés lors de l’entraînement. Toute modification dans le type de viande, les conditions de conservation ou les procédés industriels nécessite un recalibrage partiel du modèle.

Optimisation des réseaux colorimétriques
L’amélioration de la sélectivité et de la stabilité des colorants chimiques reste un enjeu. Des avancées dans la formulation des capteurs réactifs permettront d’élargir la gamme d’applications et d’accroître la précision du diagnostic.

Vers l’intégration industrielle
Les perspectives futures incluent l’intégration de ces dispositifs dans les chaînes de conditionnement, leur miniaturisation et leur connexion à des systèmes d’information (IoT) pour un contrôle qualité automatisé à grande échelle.

Conclusion

La combinaison des réseaux colorimétriques et de l’apprentissage profond offre une voie prometteuse pour la détection accélérée de la fraîcheur de la viande crue. Cette technologie, à la fois économique, rapide et précise, répond aux exigences croissantes du secteur agroalimentaire en matière de traçabilité et de sécurité. À terme, elle pourrait s’imposer comme la norme pour l’évaluation non destructive de la qualité des denrées périssables.

Source : https://www.sciencedirect.com/science/article/abs/pii/S0308814626021084?dgcid=rss_sd_all

Apprentissage automatique : détecter et prédire les maladies fongiques des plantes grâce à l’IA

Modèles avancés d'apprentissage automatique pour la détection et la prédiction des risques de maladies fongiques chez les plantes

Introduction

La gestion efficace des maladies fongiques est devenue un enjeu majeur de l'agriculture moderne. Face à la complexité croissante des pathogènes et aux défis du changement climatique, les outils traditionnels montrent leurs limites. Désormais, l'apprentissage automatique (Machine Learning, ML) offre des solutions innovantes pour détecter précocement les maladies fongiques des plantes et anticiper les risques épidémiques. Cet article explore les dernières avancées technologiques dans ce domaine, en détaillant les modèles, méthodes et applications concrètes issus de la recherche scientifique.

Aperçu des maladies fongiques des plantes

Les maladies fongiques figurent parmi les menaces les plus courantes et dévastatrices pour les cultures agricoles. Elles affectent la productivité, la qualité et la sécurité alimentaire mondiale. Les symptômes, variables selon les espèces fongiques, se manifestent par des tâches foliaires, des nécroses ou encore des dépérissements. La détection traditionnelle repose sur l'observation visuelle par des experts, processus lent et vulnérable aux erreurs humaines, renforçant la nécessité d'une automatisation via le Machine Learning.

L'apprentissage automatique : principes et enjeux

Le Machine Learning est une branche de l'intelligence artificielle qui permet aux ordinateurs d'apprendre à partir de données et de s'améliorer sans intervention explicite. Dans le contexte phytopathologique, il s'agit d'entraîner des algorithmes à reconnaître les signes distinctifs des maladies fongiques à partir d’ensembles de données, souvent massifs, issus d'images ou de mesures agricoles.

Avantages du Machine Learning pour la détection des maladies

  • Rapidité : diagnostic automatisé et quasi-instantané
  • Précision : forte capacité de discrimination entre les symptômes des différentes maladies
  • Scalabilité : applicabilité à grande échelle à différentes espèces et géographies

Sources de données et prétraitement

Les modèles de détection des maladies fongiques s'appuient principalement sur :

  • Images numériques de feuilles ou de plants
  • Données environnementales (température, humidité, etc.)
  • Informations phénotypiques et génétiques

Le prétraitement comprend l’annotation manuelle, l’augmentation de données et la normalisation pour améliorer la qualité des jeux de données, étape cruciale avant l’entraînement des modèles ML.

Méthodes de Machine Learning pour la reconnaissance des maladies

Algorithmes supervisés

Les techniques supervisées telles que les arbres de décision, les forêts aléatoires (Random Forest), les machines à vecteurs de support (SVM) et les réseaux de neurones supervisés sont les plus utilisées pour la classification des symptômes fongiques.

  • Forêts aléatoires : excellente capacité de gestion de la variance des données et robustesse face au bruit
  • SVM : efficacité pour séparer les caractéristiques non linéaires complexes des symptômes
  • Réseaux de neurones : puissants pour capter des relations subtiles dans des jeux de données volumineux

Deep Learning et applications avancées

Les modèles de deep learning, notamment les réseaux de neurones convolutifs (CNN), révolutionnent l’analyse d’images en agriculture de précision. Ils automatisent l’extraction des caractéristiques discriminantes à partir de millions d’images, améliorant significativement l’identification des maladies fongiques sur des cultures majeures comme le blé, le riz ou la tomate.

Modèles prédictifs pour l’évaluation des risques épidémiques

Au-delà de la détection, les approches prédictives intègrent des données environnementales et agronomiques pour anticiper la probabilité de flambées fongiques. Les modèles spatio-temporels couplent l’analyse d’images à des paramètres climatiques et des historiques d’occurrence, ce qui permet d’alerter en temps réel les agriculteurs sur l’imminence de risques sanitaires.

Intégration de données multisources

Pour gagner en précision, les modèles de ML fusionnent :

  • Images visuelles (RGB, hyperspectrales)
  • Données météorologiques locales
  • Capteurs de terrain connectés

Cette intégration multimodale permet une compréhension globale des facteurs déclenchants et offre une aide à la décision personnalisée.

Évaluation et validation des modèles

La robustesse des modèles s’évalue par des jeux de test indépendants, des métriques standardisées (précision, rappel, F-score) et, de plus en plus, par des études de terrain en conditions réelles. L’interprétabilité des modèles, via des techniques comme SHAP ou LIME, devient aussi essentielle pour favoriser leur adoption par la communauté agricole.

Perspectives et défis futurs

  • Amélioration des bases de données annotées : création de jeux de données ouverts et représentatifs
  • Adaptabilité des modèles à de nouveaux contextes agricoles
  • Interopérabilité avec les plateformes agricoles connectées et les drones
  • Prise en compte de la variabilité génétique et environnementale

Conclusion

Les modèles d'apprentissage automatique transforment la détection et la gestion des maladies fongiques des plantes, offrant rapidité, précision et intelligence prédictive à la filière agricole. L’intégration de ces outils dans les systèmes de gestion intégrée promet une résilience accrue des cultures et une réduction significative des pertes économiques liées aux épidémies fongiques.

Source : https://www.sciencedirect.com/science/article/pii/S0926669026012653