Archive d’étiquettes pour : intelligence artificielle

L’intelligence artificielle révolutionne la sécurité alimentaire par l’optimisation des immunoessais

L’intelligence artificielle révolutionne la sécurité alimentaire par les immunoessais : technologies et applications

Introduction

La sécurité alimentaire, pilier de la santé publique, dépend étroitement de méthodes analytiques performantes pour la détection des agents pathogènes, contaminants chimiques et allergènes. Les immunoessais, tels que les tests ELISA et les immunocapteurs, sont devenus des outils de référence pour leur rapidité, spécificité et sensibilité. Toutefois, la complexité croissante des matrices alimentaires et l’accroissement du volume de données générées imposent une évolution des méthodes analytiques. L’intelligence artificielle (IA), et notamment le machine learning, s’impose ainsi comme catalyseur de la transition vers une surveillance alimentaire plus réactive, précise et automatisée.

Les fondements des immunoessais dans la sécurité alimentaire

Les immunoessais reposent sur les interactions antigène-anticorps détectant une grande diversité d’analytes, tels que résidus de pesticides, mycotoxines ou toxines bactériennes dans les denrées alimentaires. Leur adoption s’est élargie grâce à :

  • Rapidité de détection : résultats en temps quasi-réel
  • Spécificité élevée grâce à l’utilisation d’anticorps hautement sélectifs
  • Adaptabilité à divers formats (plaque, bandelette, microfluide)

Cependant, face à la diversité des contaminants et à la variabilité des matrices alimentaires, la sensibilité et la reproductibilité des tests constituent des défis majeurs, exacerbés par l'augmentation massive des exigences réglementaires.

L’irruption de l’IA dans l’optimisation des immunoessais

L’intégration de l’intelligence artificielle permet d’optimiser plusieurs étapes critiques des immunoessais :

Prétraitement et analyse des images

Les immunoessais colorimétriques ou à fluorescence produisent des signaux souvent analysés visuellement ou par capture d’image. Les algorithmes d’IA, tels que les réseaux neuronaux convolutifs, automatisent l’interprétation des résultats, réduisant l’erreur humaine et améliorant la répétabilité. Des applications concrètes incluent l’exploitation d’appareils mobiles pour analyser les bandelettes de test via des applications dédiées.

Modélisation et calibration des réponses analytiques

Le machine learning peut modéliser la réponse complexe d'un immunoessai en fonction des variables d’environnement, des lots d’anticorps ou des différences d’échantillons. Les techniques telles que les forêts aléatoires et les SVM (machines à vecteurs de support) permettent de prédire la concentration des cibles avec plus de robustesse qu’un simple ajustement linéaire conventionnel.

Gestion et interprétation de grands volumes de données

Avec la multiplication des points de contrôle environnemental et des campagnes de screening, la quantité de données générées explose. L’IA facilite l’intégration, le stockage sécurisé et surtout l’extraction d’informations pertinentes pour :

  • Détecter rapidement de nouveaux schémas de contamination
  • Identifier des corrélations insoupçonnées entre variables
  • Alimenter les systèmes d’alerte précoce collaboratifs (partage des données au niveau mondial)

Applications emblématiques de l’IA en immunoessais alimentaires

Détection d’allergènes et de contaminants chimiques

Des solutions d’IA déployées sur smartphone permettent aujourd’hui d’obtenir et d’interpréter instantanément le résultat d’un test d’allergènes sur un produit alimentaire, minimisant le risque d’exposition accidentelle. L’IA détecte ainsi des faibles différentiations de nuances colorimétriques ou de fluorescence indétectables à l’œil nu.

Identification rapide d’agents pathogènes

En combinant microfluidique et IA, il est désormais possible de réaliser des tests multiplexés pour plusieurs pathogènes en moins d’une heure. Les résultats, centralisés dans des bases de données sécurisées, alimentent de puissants algorithmes d’analyse prédictive.

Qualité, traçabilité et conformité réglementaire

Les systèmes automatisés, appuyés par le deep learning, évaluent en continu la conformité des lots de production. Ils détectent, par l’analyse de motifs ou l’apprentissage non supervisé, des anomalies subtiles qui pourraient échapper aux contrôles conventionnels.

Défis et perspectives pour une adoption à grande échelle

Bien que l’adoption de l’IA dans les immunoessais offre d’immenses perspectives, des obstacles demeurent :

  • Qualité des ensembles de données d’entraînement, qui doivent être représentatives et exemptes de biais.
  • Sécurisation et confidentialité des données alimentaires sensibles
  • Intégration transparente avec les systèmes informatiques existants dans l’industrie agroalimentaire

À l’avenir, le développement d’algorithmes auto-adaptatifs, la miniaturisation accrue des plateformes de détection et l’avènement de bases de données mondiales pourraient transformer la surveillance alimentaire en un processus prédictif, proactif et entièrement automatisé.

Conclusion

L’intelligence artificielle joue déjà un rôle déterminant dans la redéfinition des immunoessais alimentaires. Par l’automatisation de l’analyse, la gestion de la donnée et l’amélioration des performances analytiques, l’IA accélère le passage d’une méthodologie descriptive à une stratégie dynamique de sécurité alimentaire. Cette synergie entre biotechnologie et intelligence artificielle annonce une nouvelle ère pour la surveillance et le contrôle qualité tout au long de la chaîne alimentaire.

Source : https://www.sciencedirect.com/science/article/abs/pii/S2214799326000664
Technologies non destructives pilotées par l’IA pour l’évaluation de la qualité et de la sécurité des viandes

Technologies non destructives pilotées par l’IA pour l’évaluation de la qualité et de la sécurité de la viande

Introduction

L’industrie carnée, pilier de l’agroalimentaire mondial, est confrontée à des enjeux cruciaux en matière d’évaluation rapide, précise et non destructive de la qualité et de la sécurité des viandes. Traditionnellement, les analyses reposaient sur des méthodes chimiques et physiques souvent longues, coûteuses, invasives, et générant des déchets. Avec les progrès fulgurants de l’intelligence artificielle (IA), une nouvelle génération de technologies non destructives émerge, promettant une révolution dans le contrôle en temps réel de la viande.

État des lieux des méthodes traditionnelles

La détermination de la qualité et de la sécurité de la viande impliquait jadis des tests tels que la chromatographie, la spectrométrie de masse ou des analyses microbiologiques. Bien que fiables, ces procédés présentent des limitations considérables : délai d'obtention des résultats, nécessité de détruire ou d'altérer les échantillons, interventions humaines nombreuses, dépendance à un environnement de laboratoire contrôlé et risques environnementaux liés à la manipulation de réactifs chimiques.

Technologies non destructives au service de la filière viande

Imagerie hyperspectrale

L’imagerie hyperspectrale (IHS) combine imagerie spatiale et spectroscopie pour former un « hypercube » contenant des informations spatiales et spectrales, couvrant de nombreuses longueurs d’onde. Cette technologie permet d’identifier et de visualiser la distribution de la composition chimique (eau, protéines, lipides, minéraux) et de détecter des anomalies telles que la présence de tissus anormaux, de contaminants ou de résidus. L’intégration de l’IA dans le traitement des données hyperspectrales accélère l’analyse et accroit la précision des prédictions de fraîcheur, tendreté ou présence d’agents pathogènes.

Spectroscopie proche infrarouge (NIR)

La spectroscopie NIR exploite la sensibilité des liaisons chimiques organiques à certaines longueurs d’ondes pour obtenir en temps réel des informations sur la composition de la viande (taux d’humidité, teneur en matières grasses, quantification des protéines). Couplée au machine learning, cette technique permet de modéliser avec exactitude divers paramètres de qualité et d’estimer rapidement la détérioration éventuelle due à des agents microbiens.

Imagerie par rayons X et Térahertz

Utilisée principalement pour la détection de corps étrangers et l’évaluation de la structure interne, l’imagerie par rayons X permet de cartographier les distributions de gras, d’os et d’impuretés. Les ondes térahertz, quant à elles, traversent la viande sans l’endommager et révèlent des défauts structurels invisibles à l’œil nu. L’automatisation de l’analyse via des algorithmes d’IA offre un potentiel inédit d’inspection sur ligne pour la sécurité sanitaire et la conformité des produits finis.

Spectroscopie Raman et fluorescence

La spectroscopie Raman permet une identification moléculaire fine, utile pour détecter des variations dans les protéines ou pour diagnostiquer une contamination microbienne. L’analyse de la fluorescence sert à révéler des composés altérés ou toxiques. Croisées avec des techniques d’apprentissage automatique, ces méthodes facilitent la prédiction rapide de l’évolution de la viande selon différentes conditions de stockage.

Application de l’IA dans l’analyse des résultats

L’essor du deep learning et des réseaux de neurones convolutionnels (CNN) a radicalement transformé le traitement des données générées par les technologies non destructives. L’IA apprend à repérer des schémas complexes, indécelables par l’humain, dans des volumes imposants de données multidimensionnelles.

Les modèles d’apprentissage supervisé intègrent des banques de données massives (images, spectres, signaux) pour entraîner des algorithmes à classifier, prédire ou segmenter automatiquement la qualité, l’altération, ou la sécurité des viandes à divers stades de la filière. L’intelligence artificielle s’avère déterminante pour extraire les caractéristiques pertinentes, réduire le temps d’inspection et fiabiliser les diagnostics, tout en permettant une adaptation aux spécificités de chaque chaîne de transformation.

Avantages clés pour l’industrie agroalimentaire

  • Contrôle en temps réel : Surveillance continue sur ligne de production, permettant une réponse immédiate aux écarts de qualité ou de sécurité.
  • Réduction des déchets : Absence de prélèvement destructeur, respect de l'intégrité des produits et diminution de la perte matière.
  • Automatisation et traçabilité : Moins de subjectivité humaine, historique de chaque lot, détection précoce des non-conformités.
  • Adaptabilité et évolutivité : Les modèles IA évoluent avec l’enrichissement des bases de données et peuvent être transférés à de nouveaux types de viandes ou procédés.

Défis et perspectives

Bien que les performances de ces solutions soient prometteuses, des défis subsistent : nécessité d’une standardisation des calibrations, coût d’investissement initial dans les équipements, complexité du transfert industriel, et gestion de la diversité biologique des viandes. Le partenariat entre chercheurs, industriels et développeurs en IA sera déterminant pour lever ces freins.

À terme, l’intégration de systèmes non destructifs boostés par l’IA à chaque étape de la chaîne de valeur favorisera une production carnée plus sûre, écologique et compétitive, adaptée aux attentes croissantes des consommateurs et des instances de régulation.

Conclusion

L'association entre technologies non invasives et intelligence artificielle ouvre une ère nouvelle pour l’industrie carnée, favorisant une gestion de la qualité et de la sécurité en temps réel, plus efficace et durable. L’évolution rapide de ces outils et la baisse attendue des coûts d’accès devraient généraliser leur adoption, assurant une viande saine, traçable et de qualité supérieure, tout en optimisant les ressources industrielles à l’échelle mondiale.

Source : https://www.mdpi.com/2304-8158/15/15/2592

Modélisation avancée des facteurs de bioconcentration des PFAS chez les poissons via intelligence artificielle

Modélisation des facteurs de bioconcentration des PFAS dans les poissons via caractéristiques moléculaires et recherche d’architectures neuronales

Introduction

Les substances per- et polyfluoroalkylées (PFAS) suscitent une inquiétude croissante pour leur accumulation dans les organismes aquatiques, notamment les poissons. L'évaluation du facteur de bioconcentration (BCF), reflétant la propension d'un composé à s'accumuler dans les tissus vivants, s'avère cruciale pour l’analyse du risque sanitaire et environnemental associé à l’exposition humaine via la chaîne alimentaire. Le développement de méthodes prédictives robustes, exploitant à la fois les caractéristiques moléculaires et des outils d’intelligence artificielle avancés, constitue donc un enjeu prioritaire pour la gestion des PFAS dans les milieux aquatiques.

Objectifs et contexte de l’étude

Cet article présente une approche visant à prédire les BCF des PFAS dans les tissus de poissons en s’appuyant sur des attributs structuraux moléculaires et en appliquant la recherche d'architectures neuronales (Neural Architecture Search, NAS). Les motivations sont triples :

  • Accroître la précision des prédictions de BCF grâce à la modélisation basée sur l'apprentissage automatique;
  • Automatiser le choix de l’architecture optimale des réseaux de neurones pour s’adapter à la complexité chimique des PFAS;
  • Mieux comprendre le lien entre structure moléculaire et bioconcentration au travers d'une interprétation poussée des modèles générés.

Données et sélection des descripteurs moléculaires

L’étude s’appuie sur une base de données intégrant des mesures empiriques de BCF pour un éventail de PFAS chimiques détectés dans les tissus de poissons. Les paramètres moléculaires sont extraits pour chaque composé à partir de différentes classes de descripteurs, notamment :

  • Descripteurs topologiques (liés à la connectivité atomique et la ramification)
  • Propriétés physico-chimiques telles que la logP, l’hydrophobicité ou la polarité
  • Indices électroniques (potentiel de charge, perte d'électrons, etc.)
  • Paramètres de taille et de forme moléculaires

La sélection optimale de ces variables est essentielle pour permettre à l’algorithme neuronal de capturer les dynamiques discriminantes responsables de l’accumulation différente de chaque PFAS.

Recherche d’architecture neuronale automatisée

Plutôt que de recourir à des configurations standards de réseaux de neurones, cette approche exploite la recherche automatisée d’architecture (NAS). Le processus procède ainsi :

  1. Exploration de différentes structures de réseaux (nombre/organisation des couches cachées, fonctions d’activation, connexions internes, etc.)
  2. Optimisation de l’architecture sur la base de la performance prédictive, grâce à la validation croisée sur les données de BCF
  3. Sélection des architectures affichant le compromis optimal entre fidélité de la prédiction et minimisation du surapprentissage

Cette démarche permet de dépasser les limites inhérentes à la conception manuelle, offrant une flexibilité et une adaptabilité supérieures pour traiter la diversité structurale des PFAS.

Résultats et performances des modèles

Les modèles entraînés via NAS sur l’ensemble des descripteurs moléculaires montrent une capacité supérieure ou équivalente aux approches classiques pour prédire le BCF des PFAS dans les poissons. Quelques points saillants des résultats :

  • Amélioration significative de la précision prédictive comparée aux modèles statistiques linéaires, notamment grâce à une meilleure prise en compte des interactions complexes entre variables moléculaires.
  • Capacité à détecter des relations non linéaires; certaines caractéristiques moléculaires influencent la bioconcentration de manière synergique ou antagoniste.
  • Généralisation robuste aux composés en dehors du jeu d’entraînement, renforçant la valeur pratique de la méthode.
  • Facilité d’interprétation partielle des modèles grâce à des analyses d’importance des variables, mettant en avant le rôle de certains groupes fonctionnels ou paramètres physiques spécifiques dans l’accumulation des PFAS.

Implications pour l’évaluation environnementale et toxicologique des PFAS

L’intégration systématique de la modélisation neurale automatisée permet d’enrichir considérablement la panoplie d’outils d’évaluation du devenir des PFAS dans les milieux aquatiques. Elle offre des perspectives précieuses pour :

  • Affiner les modèles d’exposition des consommateurs de poissons (dont l’humain, via la chaîne alimentaire).
  • Prioriser les PFAS à surveiller selon leur potentiel d'accumulation prédite dans les tissus biotiques.
  • Soutenir la prise de décision réglementaire et la gestion des risques liés à la pollution aux PFAS.

Limites et directions futures

Si cette méthode montre de robustes avancées, plusieurs défis persistent :

  • La disponibilité et la qualité des données expérimentales de BCF restent un facteur limitant.
  • L’interprétabilité complète des réseaux de neurones demeure complexe, même avec des analyses avancées d’importance de variables.
  • Des recherches complémentaires sont nécessaires pour améliorer la couverture de la diversité structurale des PFAS et explorer davantage la variabilité inter-espèce chez les poissons.

Conclusion

La combinaison de descripteurs moléculaires finement sélectionnés et de la recherche automatisée d’architectures neuronales représente une avancée considérable dans la prédiction des facteurs de bioconcentration des PFAS dans les poissons. Cette approche s’impose comme un outil de référence pour l’évaluation raisonnée du transfert de contaminants dans les réseaux trophiques aquatiques.

Source : https://www.sciencedirect.com/science/article/abs/pii/S2213343726034032

Cadre intelligent pour la classification automatisée de la sévérité de la brûlure bactérienne du riz via l’imagerie UAV multispectrale

Classification automatisée de la sévérité de la brûlure bactérienne du riz grâce à l’imagerie multispectrale UAV

Introduction

La brûlure bactérienne des feuilles (BLB – Bacterial Leaf Blight) du riz représente l’une des principales menaces phytopathologiques pour la production de riz à l’échelle mondiale. Traditionnellement, l’évaluation de la gravité de cette maladie repose sur des inspections visuelles humaines, souvent subjectives, chronophages et peu évolutives. Afin d'améliorer la fiabilité et l'efficacité de ces opérations, ce cadre propose une approche innovante associant l’imagerie multispectrale par drones (UAV) et des algorithmes de classification automatisée.

Méthodologie de Collecte et Prétraitement des Données

Acquisition des Images Multispectrales

Des drones équipés de capteurs multispectraux ont survolé des parcelles de riz à différents stades de développement. Les bandes spectrales concernées incluent le visible (bleu, vert, rouge) et le proche infrarouge (NIR), permettant la captation de signaux essentiels à la détection des différents niveaux de stress foliaire.

Prétraitement, Correction et Extraction des Traits Spectraux

Les images brutes ont d’abord subi un étalonnage radiométrique et géométrique afin de garantir l’uniformité des données. Plusieurs indices spectraux, tels que le NDVI (Normalized Difference Vegetation Index) et le GNDVI (Green Normalized Difference Vegetation Index), sont ensuite extraits pour renforcer la capacité discriminante des modèles vis-à-vis des symptômes de la BLB.

Développement du Cadre de Classification Automatisée

Annotation et Étiquetage

Pour entraîner le modèle, des experts agronomes ont annoté manuellement les données d’imagerie UAV pour séparer les différents niveaux de sévérité de la BLB (sain, légère, modérée, sévère). Ce corpus annoté sert de base à l’apprentissage supervisé des algorithmes.

Génération des Features

Des vecteurs de caractéristiques ont été générés à partir des données multispectrales en combinant indices végétatifs, paramètres texturaux et statistiques du signal pour chaque parcelle. Cette approche multivariée permet d’englober la diversité des manifestations visuelles de la maladie.

Sélection et Évaluation des Algorithmes de Classification

Divers algorithmes ont été testés, notamment les forêts aléatoires, les machines à vecteurs de support (SVM) et les réseaux de neurones convolutionnels (CNN). Chaque algorithme a été évalué à l’aide de métriques telles que la précision, l’exactitude, le rappel et le score F1, avec validation croisée sur des ensembles de test séparés.

Résultats : Performances de la Classification

L’approche CNN exploitant l’intégralité des bandes multispectrales s’est avérée supérieure, atteignant une précision globale supérieure à 92% pour la distinction des quatre degrés de sévérité. L’intégration d’indices végétatifs, combinée à l’information texturale, améliore considérablement la différenciation entre des niveaux de maladies proches, notamment entre stades modérés et sévères.

Les algorithmes plus traditionnels (forêts aléatoires, SVM) offrent également de bons résultats mais avec une légère baisse de performance, principalement due à leur capacité moindre à intégrer les complexités spatiales et spectrales fournies par les images UAV.

Discussion : Avantages, Limites et Perspectives

Points forts du Cadre Automatisé

  • Objectivité accrue : L’analyse automatisée réduit les biais humains et fournit des résultats constants.
  • Rapidité et scalabilité : Grâce à l’automatisation, de larges superficies peuvent être analysées en temps réel ou quasi réel.
  • Multispectralité : L’exploitation de la richesse spectrale permet une détection précoce ainsi qu’une quantification précise de la sévérité.

Limites identifiées

  • Dépendance à la qualité des annotations : Le système est limité par la précision des étiquetages effectués manuellement au démarrage.
  • Variabilité environnementale : Les conditions de lumière, d’humidité et de couverture nuageuse peuvent parfois influer sur la fiabilité de l’imagerie.

Perspectives d’amélioration

L’intégration de données temporelles via des suivis multisaisonniers pourrait augmenter la résilience du système face aux variations intra-saisonnières. De plus, le couplage avec d’autres types de capteurs (thermique, hyperspectral) et l’adaptation à d’autres cultures ou pathogènes ouvrent la voie à une généralisation de ce cadre technologique.

Conclusion

Ce cadre de classification automatisée basé sur l’imagerie UAV multispectrale et le traitement avancé d’images propose une avancée majeure pour le diagnostic et la gestion de la brûlure bactérienne du riz. Grâce à son adaptabilité, il constitue un pivot pour la modernisation de la phytopathologie de terrain et l’optimisation des interventions agronomiques.

Source : https://www.mdpi.com/2073-4395/16/15/1461

Deep Learning pour la détection des maladies du caféier : Enjeux pour la traçabilité dans l’e-commerce agricole

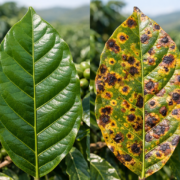
Deep Learning et détection des maladies du caféier : Défis et perspectives pour la traçabilité de la qualité dans l’e-commerce agricole

Introduction

La culture du café, essentielle à l’économie mondiale et surtout cruciale pour de nombreux pays producteurs, fait face à des risques sanitaires majeurs dus aux maladies fongiques et bactériennes touchant les feuilles. Ces maladies compromettent aussi bien la quantité que la qualité de la récolte. L’émergence de l’e-commerce agricole, dont les plateformes numériques facilitent le commerce du café, accentue les besoins en traçabilité et en maintien de la qualité. L’intégration du deep learning dans la détection précoce des maladies du caféier représente une avancée techno-scientifique inédite, apportant de nouvelles réponses à ces défis complexes.

Les enjeux de la détection des maladies du caféier

La détection manuelle traditionnelle, longtemps pratiquée dans les plantations, se révèle chronophage, peu fiable et sensible à l’expertise humaine. Face à la variété des symptômes foliaires et aux conditions de culture mouvantes, la précision du diagnostic repose fortement sur la compétence de chaque observateur. Adoptant des modèles d’apprentissage profond, les chercheurs cherchent à automatiser ce processus, tendre vers l’universalité des diagnostics et fiabiliser la chaîne de valeur.

Maladies principales du caféier

  • Rouille (Hemileia vastatrix)
  • Cercosporiose (Cercospora coffeicola)
  • Taches bactériennes (Pseudomonas syringae)

La présence desdites maladies, mal maîtrisée, menace le rendement mais aussi la réputation qualitative des lots sur les marchés internationaux.

Fondements du Deep Learning appliqué à la phytopathologie

Le deep learning, sous-branche de l’intelligence artificielle, traite l’analyse d’images foliaires via des réseaux de neurones convolutifs (CNN) capables d’extraire caractéristiques visuelles complexes. Ces modèles vont au-delà du simple classement d’images en apprenant à identifier des motifs subtils, spécifiques à chaque pathologie. Les recherches actuelles privilégient des architectures telles que ResNet, VGG ou EfficientNet, connues pour leur robustesse statistique.

Étapes du pipeline d’apprentissage profond

  1. Collecte d’images de feuilles de caféier, annotées par des experts.
  2. Prétraitement des images (suppression du bruit, augmentation de données, correction colorimétrique).
  3. Entraînement du modèle CNN pour distinguer feuilles saines et malades.
  4. Validation et test sur un ensemble d’images inédites.

Limites actuelles et problématiques de généralisation

Malgré les progrès, plusieurs obstacles entravent la généralisation à grande échelle :

  • Variabilité environnementale : luminosité, arrière-plan, stade de la feuille altèrent la qualité des images.
  • Données annotées limitées : La constitution de bases d’images couvrant exhaustivement toutes les classes/variétés reste très coûteuse.
  • Overfitting : Les modèles surapprennent parfois les données disponibles sans capacité à s’adapter à de nouveaux cas.
  • Interprétabilité réduite : Les CNN agissent comme des « boîtes noires », rendant l’explication des résultats difficile pour les utilisateurs finaux.

Des techniques de régularisation, de transfert d’apprentissage et l’intégration de données issues de réseaux collaboratifs sont testées pour pallier ces limites.

Vers une traçabilité renforcée dans le secteur agricole via l’IA

La fiabilité de la détection automatisée s’inscrit au cœur des problématiques de traçabilité qui façonnent le marché du café en e-commerce. Permettre à chaque lot de bénéficier d’une certification numérique de son état phytosanitaire favorise l’instauration de nouvelles normes de transparence :

  • Intégration blockchain pour enregistrer, authentifier et tracer les diagnostics associés à chaque lot exporté.
  • Rapidité des contrôles sur les flux logistiques, limitant propagation et pertes de qualité.
  • Renforcement de la confiance entre producteurs, négociants et consommateurs finaux via un suivi dynamique basé sur l’IA.

Perspectives et recommandations pour l’implémentation pratique

L’industrialisation de ces solutions requiert des efforts coordonnés :

  • Élaboration de jeux de données multi-régionaux en collaboration avec les coopératives agricoles.
  • Déploiement de modèles légers pouvant être embarqués sur smartphones ou drones.
  • Formation des acteurs de terrain à l’usage des technologies de deep learning.
  • Collaboration interdisciplinaire pour l’adaptation des outils aux contraintes réelles des plantations.

Les réseaux de neurones doivent être continuellement réentraînés pour intégrer les mutations pathologiques émergentes et renforcer leur capacité de prédiction.

Conclusion

L’emploi du deep learning pour la détection anticipée et automatisée des maladies du caféier s’impose comme un levier d’excellence pour la traçabilité et la maîtrise de la qualité dans l’e-commerce agricole. Malgré des défis méthodologiques persistants – variabilité des données, manque de transparence des modèles, nécessité de bases d’images étoffées – l’intégration progressive de solutions IA dans la chaîne de production promet une transformation durable du secteur caféier. Le futur se dessine autour d’écosystèmes collaboratifs, associant agriculteurs, experts en données et acteurs de la supply chain pour une agriculture connectée, transparente et qualitative.

Source : https://www.mdpi.com/2077-0472/16/15/1664

Évaluation de la Qualité des Produits de la Mer Surgelés : Technologies de Détection et IA

Évaluation de la Qualité des Produits de la Mer Surgelés : Progrès dans les Technologies de Détection et l'Intelligence Artificielle

Introduction

La préservation optimale de la qualité des produits de la mer surgelés revêt une importance primordiale dans le secteur agroalimentaire. Face à la demande croissante de produits sains, sûrs et au goût préservé, les industries de transformation et de distribution se tournent vers des méthodes innovantes. Les technologies de détection avancées, couplées à l’intelligence artificielle (IA), redéfinissent les standards de contrôle qualité, en rendant leurs processus plus rapides, précis et adaptés aux exigences du marché.

Les Défis de la Qualité des Produits de la Mer Surgelés

Le maintien de la qualité au cours de la congélation, du stockage et de la distribution est entravé par divers facteurs :

  • Variabilité naturelle des espèces et des conditions d’élevage/pêche
  • Altérations physico-chimiques induites par la congélation
  • Dégradation microbienne potentielle pendant la chaîne du froid

La méthodologie classique d’évaluation (essais sensoriels, analyses chimiques/microbiologiques) présente des limites : lenteur, coût élevé, subjectivité et destruction partielle des échantillons. Les alternatives non destructives et automatisées sont donc en plein essor.

Émergence des Technologies Avancées de Détection

Spectroscopie

Des techniques telles que la spectroscopie dans le proche infrarouge (NIR), la spectroscopie Raman ou l’imagerie hyperspectrale s’imposent comme des outils centraux pour caractériser en temps réel l’état des produits surgelés. Elles permettent :

  • L’identification rapide de composés chimiques spécifiques (protéines, lipides, eau)
  • Le suivi des marqueurs de détérioration (oxydation, dénaturation des protéines)
  • L’analyse à travers l’emballage, sans contact direct avec le produit

Capteurs Électroniques

Les nez électroniques (e-noses), langues électroniques (e-tongues) et biocapteurs offrent un complément essentiel pour détecter les modifications aromatiques, l’évolution des saveurs et la présence de contaminants. Ces dispositifs intègrent divers capteurs physico-chimiques dont les signaux sont interprétés via des algorithmes d’intelligence artificielle.

Imagerie Avancée

Les systèmes d’imagerie hyperspectrale combinent une analyse spatiale et spectrale, permettant de cartographier la distribution de la fraîcheur, des tissus abîmés ou de la teneur en givre. Ces technologies facilitent la discrimination de lots hétérogènes et l'automatisation du tri.

Rôle de l’Intelligence Artificielle

Algorithmes de Traitement des Données

La masse de données issue des analyses spectrales et des capteurs nécessite une capacité de traitement et d’interprétation sans précédent. Les techniques de machine learning (apprentissage automatique) — SVM, réseaux de neurones profonds, algorithmes d’ensemble — transforment ces informations complexes en décisions opérationnelles :

  • Classification rapide des niveaux de fraîcheur
  • Détection des anomalies et prédiction de la durée de vie résiduelle
  • Optimisation des paramètres de congélation et d’entreposage

IA et Automatisation

L’intégration de l’IA dans les chaînes de production se traduit par la mise en place de systèmes experts capables de surveiller et contrôler la qualité en continu. Les modèles prédictifs issus du deep learning assurent une adaptation dynamique face aux variations des matières premières et des conditions industrielles.

Applications et Études de Cas

  • Détection de la détérioration du poisson : l’imagerie hyperspectrale couplée à des réseaux de neurones détecte les tissus oxydés sans ouvrir l’emballage.
  • Contrôle de la texture : des analyses spectroscopiques assistées par IA permettent de prédire la tendreté ou la fermeté selon le type de surgelé traité.
  • Tracabilité et authentification : les signatures spectralo-chimiques spécifiques identifient l’espèce, l’origine et le mode de transformation.

Bénéfices et Limitations Actuelles

Atouts

  • Rapidité et non-invasivité
  • Réduction des coûts et du gaspillage
  • Objectivation de l’évaluation qualité
  • Potentiel d’intégration dans la surveillance en ligne et les lignes automatisées

Freins

  • Besoin de calibration robuste et d’apprentissage personnalisé selon les espèces et les process
  • Nécessité de bases de données massives et d’annotations fiables pour entraîner les algorithmes
  • Investissements initiaux importants pour l’équipement et la formation

Perspectives d’Évolution

À l’avenir, les synergies entre capteurs intelligents, IA évolutive et connectivité IoT révolutionneront la gestion de la qualité dans les filières des produits de la mer surgelés. La convergence de ces technologies permettra de garantir la fraîcheur, la sécurité et l’authenticité, tout en fournissant aux industriels et aux consommateurs des outils d’aide à la décision puissants et interactifs.

Cette transition vers une numérisation complète de l’évaluation qualité s’inscrit pleinement dans la dynamique de l’industrie alimentaire 4.0, privilégiant traçabilité, durabilité et excellence.

Source : https://www.mdpi.com/2304-8158/15/16/2799

Machine Learning et Deep Learning : défis et enjeux pour l’analyse des aliments

Enjeux et défis du Machine Learning et Deep Learning appliqués à l'analyse des aliments : synthèse et perspectives

Introduction à l'intelligence artificielle et aux sciences alimentaires

L'application du machine learning (ML) et du deep learning (DL) dans l'analyse des aliments s'impose aujourd'hui comme un levier incontournable pour moderniser et fiabiliser les procédés de contrôle qualitatif et quantitatif en agroalimentaire. Fortes d'une capacité inégalée à extraire des motifs complexes et à traiter de vastes volumes de données, ces technologies disruptives s'inscrivent au cœur de l'innovation, bouleversant les méthodes analytiques traditionnelles basées sur les approches statistiques classiques.

Méthodes analytiques : évolution vers l'intelligence artificielle

L'analyse des aliments faisait historiquement appel à des méthodes manuelles et destructives, lentes ou coûteuses. Désormais, la croissance des données issues de la spectroscopie, de l'imagerie hyperspectrale ou des capteurs intelligents impose des modèles prédictifs puissants et automatisés. Les réseaux neuronaux, support vector machines, arbres de décision et autres algorithmes avancés permettent une extraction automatisée de caractéristiques, facilitant ainsi la précision de l'identification, de la classification, voire de la quantification de nombreux paramètres alimentaires.

Exemples d'applications :

  • Détection de contaminants et d'adultération (par exemple, pesticides, mycotoxines, mélamine)
  • Analyse de la composition nutritionnelle et authentification géographique
  • Caractérisation des propriétés sensorielles (goût, couleur, texture)

Principales difficultés rencontrées

1. Qualité et quantité des données

L'un des obstacles majeurs reste l'accès à des jeux de données robustes, homogènes et largement annotés. Le manque de diversité, les déséquilibres de classe et l’absence de données de référence limitent la fiabilité des modèles, tandis que la variabilité extrême des matrices alimentaires ajoute une couche de complexité inutilisée dans de nombreux domaines technologiques.

2. Interprétabilité des modèles

Le deep learning, bien qu’extrêmement performant, est souvent considéré comme une "boîte noire" dont les résultats ne sont pas toujours explicables. Or, dans un secteur réglementé comme l’agroalimentaire, la traçabilité et l’explicabilité des résultats priment pour garantir la confiance des parties prenantes et des autorités de contrôle.

3. Portabilité et robustesse

L’apprentissage des modèles peut s’avérer spécifique à un équipement, une matrice ou un environnement donné, rendant leur transfert difficile d’un laboratoire à l’autre ou d’une production à l’autre. La robustesse face au bruit, aux variations saisonnières ou géographiques est une exigence impérative.

4. Coûts computationnels et choix d’architecture

L’entraînement de modèles complexes exige des ressources de calcul massives, parfois incompatibles avec les équipements embarqués trouvés en chaîne de production. Le choix et l'optimisation des architectures de réseaux nécessitent une expertise élevée, ce qui constitue un second défi.

Optimisation et bonnes pratiques en intelligence artificielle alimentaire

Prétraitement des données

Le prétraitement (normalisation, extraction de caractéristiques, nettoyage des données) conditionne fortement la performance des modèles. L’automatisation de cette étape par l’intégration de méthodes intelligentes telles que la réduction de dimensionnalité ou le feature extraction permet de renforcer la reproductibilité des analyses tout en réduisant la dépendance à l’expertise humaine.

Data augmentation et transfert de connaissances

La data augmentation – générant artificiellement de nouvelles observations à partir de petits échantillons – s'avère essentielle pour pallier le manque de données alimentaires, tandis que l’apprentissage par transfert tire parti de modèles préentraînés, accélérant l’adaptation à de nouvelles tâches ou matrices.

Gestion des biais et validation croisée

La correction des biais inhérents à la collecte des données s’impose, passant par une validation croisée rigoureuse et l’emploi de différentes métriques d’évaluation (accuracy, précision, rappel, F1-score, courbes ROC/AUC…). Les algorithmes explicatifs comme LIME ou SHAP deviennent essentiels pour comprendre les décisions du modèle.

Avancées récentes et perspectives

L'intégration simultanée de sources de données multiples (multi-omics, spectroscopie, vision, données sensorimétriques) ainsi que l’essor de l’apprentissage automatique auto-encadré (self-supervised learning) augurent une automatisation accrue et une détection de plus en plus fiable de la fraude, de la contamination ou de l’authenticité des aliments. Le développement de frameworks open source favorise la reproductibilité et le partage des modèles à grande échelle.

Vers une adoption industrielle généralisée

Les collaborations multidisciplinaires, la normalisation des protocoles et la création de bases de données publiques standardisées sont clés pour accélérer le déploiement de l’IA en alimentaire. Ce processus est consolidé par de nouveaux modèles hybrides (statistiques-deep learning) et l’essor du cloud computing, réduisant les coûts et assurant la sécurité des données.

Conclusion

L’utilisation du machine learning et du deep learning dans l’analyse alimentaire a le potentiel de transformer durablement le secteur en termes de rapidité, précision et prédictivité. Surmonter les défis liés à la gestion des données, à l’interprétation des résultats et à la robustesse des modèles doit rester une priorité. En multipliant les initiatives de partage des données et en investissant dans la recherche collaborative, le secteur alimentaire pourra pleinement bénéficier de la révolution de l’IA.

Source : https://www.sciencedirect.com/science/article/pii/S0021967326005054?dgcid=rss_sd_all

Futur de l’IA dans la surveillance et la gestion de la santé forestière

Perspectives futures du rôle de l'IA dans la surveillance de la santé forestière

Introduction

L'utilisation croissante de l'intelligence artificielle (IA) dans la surveillance de la santé des forêts représente une transformation majeure pour la gestion forestière moderne. Face à l'ampleur des menaces, telles que les espèces invasives, les maladies émergentes et les perturbations climatiques, les solutions automatisées et intelligentes deviennent indispensables. Cet article explore les perspectives actuelles et futures du déploiement de l'IA dans ce secteur critique.

État actuel de l'IA en surveillance forestière

Les systèmes de surveillance forestière traditionnels reposaient principalement sur des observations humaines et des protocoles de collecte de données manuels. L'intégration de l'IA, couplée à des réseaux de capteurs, des images satellites haute résolution et des drones, permet désormais d'automatiser l’acquisition, l’analyse et l’interprétation des données.

Les applications existantes de l’IA dans la santé forestière incluent :

  • Détection automatisée des maladies grâce à l’apprentissage profond sur des images aériennes et satellites.
  • Classification des essences d’arbres par réseaux de neurones convolutifs appliqués à des données hyperspectrales.
  • Suivi des infestations d’insectes et pathogènes via l’analyse temporelle des indicateurs de stress.
  • Prédictions des risques de feux de forêt par des modèles d’apprentissage supervisé utilisant des données météorologiques et écologiques intégrées.

Cette évolution accroît drastiquement l'efficacité de la surveillance, tout en générant des ensembles de données massifs facilitant la recherche et la prise de décision.

Défis techniques et organisationnels

Malgré les avancées, plusieurs défis techniques persistent :

Hétérogénéité des données

La diversité des sources de données (télédétection, stations au sol, images drones) complique l’intégration et l’harmonisation nécessaires pour une analyse robuste. Les modèles d’IA doivent être capables de traiter efficacement des entrées multimodales.

Limites des algorithmes actuels

La généralisation reste un obstacle majeur : des modèles entraînés sur une forêt spécifique peinent à s’adapter à d’autres écosystèmes ou à anticiper des conditions inédites générées par le changement climatique.

Accès aux infrastructures et coûts

La mise en place de systèmes d’IA sophistiqués requiert des investissements considérables dans l’infrastructure informatique, le stockage des données et la connectivité, notamment dans les régions forestières éloignées.

Gouvernance, confidentialité et éthique

Les questions relatives à la propriété des données, à la confidentialité, à la transparence algorithmiques et aux impacts sociaux-environnementaux exigent un encadrement réglementaire solide.

Vers une nouvelle génération d’IA pour la surveillance forestière

Pour relever ces défis, plusieurs tendances émergentes ouvrent de nouvelles possibilités :

IA fédérée et edge computing

L’informatique en périphérie permet de traiter les données localement sur le terrain, réduisant la latence et les besoins en bande passante. L’apprentissage fédéré, quant à lui, offre la capacité d’entraîner des modèles collaboratifs sans centraliser les données sensibles.

Modélisation hybride et prédictive

L’intégration des connaissances écologiques avec l’apprentissage statistique, via des approches hybrides, peut renforcer la capacité des IA à inférer des tendances et à anticiper de nouvelles menaces, dépassant les limites des simples modèles “boîte noire”.

Participations citoyennes et IA collaborative

L’engagement de communautés locales et de réseaux de surveillants citoyens, couplé à l’IA (ex. via des applications mobiles pour signalements), favorise la détection précoce et enrichit la base de connaissances du système.

Impacts attendus sur la gestion forestière

Le recours massif à l'IA laisse présager des changements profonds dans la gestion des forêts :

  • Alerte et prévention améliorées grâce à la détection précoce des maladies et parasites, limitant les dégâts.
  • Optimisation de l’allocation des ressources pour cibler les interventions de gestion en fonction des risques prévus et des données temps réel.
  • Décisions stratégiques éclairées, basées sur des analyses prédictives robustes prenant en compte la dynamique climatique et anthropique.
  • Monitoring continu et large échelle impossible à réaliser efficacement par des moyens humains seuls.

Perspectives d’avenir et recommandations

L’avenir de l’IA dans la surveillance de la santé des forêts sera conditionné par :

  • L’amélioration continue des algorithmes pour une meilleure adaptabilité inter-écosystèmes.
  • Des protocoles de standardisation des données et d’interopérabilité logicielle.
  • Une gouvernance inclusive, assurant l’accès équitable aux outils d’IA et préservant la souveraineté des données locales.
  • Le développement de cadres éthiques et de transparence pour renforcer la confiance des parties prenantes.

Conclusion

L’IA transforme radicalement la surveillance de la santé forestière, devenant un levier incontournable pour faire face aux défis environnementaux croissants. Malgré les obstacles techniques, économiques et éthiques, l’innovation et la collaboration internationale ouvrent la voie à une nouvelle ère de gestion durable des ressources forestières. Investir dans ces technologies et leur cadre d’utilisation responsable est une condition clé pour préserver l’intégrité et la résilience des forêts du futur.

Source : https://www.mdpi.com/1999-4907/17/6/700