Archive d’étiquettes pour : intelligence artificielle

Prédire la contamination des carcasses de poulets par Campylobacter grâce au microbiote

Une nouvelle approche pour surveiller Campylobacter dans la filière avicole

La contamination des carcasses de poulets de chair par les bactéries du genre Campylobacter représente un enjeu important de sécurité alimentaire. Souvent présentes dans le microbiote intestinal des volailles, ces bactéries peuvent se diffuser au cours de l’abattage et contaminer les carcasses destinées à la consommation.

Une étude publiée dans la revue BMC Microbiology s’intéresse à une méthode de prédiction fondée sur l’analyse du microbiote et l’intelligence artificielle. Les chercheurs ont notamment évalué l’intérêt de l’algorithme de forêt aléatoire, ou random forest, pour identifier les profils microbiens associés à la présence de Campylobacter sur les carcasses de poulets de chair.

Le microbiote comme indicateur de contamination

Le microbiote regroupe l’ensemble des micro-organismes présents dans un environnement donné. Dans le cas des volailles, sa composition peut varier selon l’âge des animaux, leur alimentation, les conditions d’élevage, la biosécurité ou encore les étapes de transformation à l’abattoir.

L’hypothèse étudiée est que certaines communautés bactériennes peuvent être liées à la présence ou à l’absence de Campylobacter. En analysant ces associations, il devient possible d’identifier des marqueurs microbiens susceptibles de servir d’indicateurs précoces de contamination.

Cette approche complète les méthodes microbiologiques classiques, qui reposent généralement sur la collecte d’échantillons et la mise en œuvre d’analyses de laboratoire. Ces techniques restent indispensables, mais elles peuvent nécessiter du temps et fournir une information limitée sur les interactions entre les différentes bactéries présentes dans l’échantillon.

Le rôle de l’algorithme random forest

La forêt aléatoire est une méthode d’apprentissage automatique qui combine les résultats de nombreux arbres de décision. Chaque arbre analyse les données selon des critères différents, puis l’algorithme agrège les résultats afin d’obtenir une prédiction plus robuste.

Dans cette étude, le modèle a été utilisé pour examiner les données relatives à la composition microbienne des carcasses et déterminer si elles pouvaient permettre de prédire leur statut vis-à-vis de Campylobacter.

L’intérêt de cette méthode repose notamment sur sa capacité à traiter un grand nombre de variables et à mettre en évidence les facteurs les plus informatifs. Elle peut ainsi contribuer à repérer des groupes bactériens ou des profils microbiens associés à un risque accru de contamination.

Vers une surveillance plus ciblée

Une méthode de prédiction basée sur le microbiote pourrait aider les professionnels à mieux cibler les contrôles dans les élevages et les abattoirs. Elle pourrait également contribuer à repérer plus rapidement les situations présentant un risque particulier et à adapter les mesures de prévention.

À terme, ce type d’outil pourrait s’intégrer dans une stratégie de surveillance combinant plusieurs sources d’information :

  • les analyses microbiologiques traditionnelles ;
  • les données relatives à l’élevage et à l’alimentation ;
  • les conditions de transport et d’abattage ;
  • la composition du microbiote ;
  • les modèles d’apprentissage automatique.

Une telle combinaison permettrait de passer d’une surveillance essentiellement réactive à une approche davantage prédictive et préventive.

Des résultats à interpréter avec prudence

Même lorsqu’un modèle statistique obtient de bonnes performances, sa transposition à d’autres élevages ou à d’autres abattoirs doit être évaluée avec attention. La composition du microbiote peut varier en fonction des pratiques d’élevage, des régions, des saisons et des méthodes d’échantillonnage.

La fiabilité d’un modèle dépend également de la qualité et de la diversité des données utilisées pour son entraînement. Des validations complémentaires sur des jeux de données indépendants sont donc nécessaires avant d’envisager une utilisation à grande échelle.

Par ailleurs, une corrélation entre certains microorganismes et la présence de Campylobacter ne démontre pas nécessairement une relation de cause à effet. Les marqueurs identifiés devront être étudiés plus précisément afin de comprendre leur rôle biologique et leur potentiel comme outils de contrôle.

Une piste prometteuse pour la sécurité alimentaire

L’étude consacrée à la prédiction de la contamination des carcasses de poulets par Campylobacter illustre le potentiel des approches combinant microbiologie et intelligence artificielle. En exploitant les informations contenues dans le microbiote, les chercheurs cherchent à développer des outils capables d’anticiper les risques et d’améliorer la maîtrise de la contamination dans la chaîne avicole.

Cette démarche ne remplace pas les analyses de référence, mais elle pourrait les compléter en fournissant une meilleure compréhension des écosystèmes microbiens et des facteurs associés à la contamination. Des travaux supplémentaires seront toutefois nécessaires pour confirmer la robustesse de ces modèles et déterminer les conditions de leur déploiement opérationnel.

SDA-Net : une approche par vision artificielle pour évaluer les maladies des crevettes

SDA-Net : la vision par ordinateur au service de la santé des crevettes

La détection précoce des maladies est un enjeu majeur pour l’aquaculture. Dans les élevages de crevettes, une infection peut se propager rapidement et entraîner d’importantes pertes économiques. Les méthodes traditionnelles reposent souvent sur l’observation visuelle et l’expertise humaine, deux approches qui peuvent être longues, subjectives et difficiles à déployer à grande échelle.

L’étude consacrée à SDA-Net présente un cadre fondé sur la vision par ordinateur afin d’automatiser l’évaluation de l’état sanitaire des crevettes à partir d’images.

Un diagnostic assisté par l’intelligence artificielle

SDA-Net s’inscrit dans le développement de solutions d’intelligence artificielle destinées à analyser les caractéristiques visuelles des crevettes. Le système peut notamment exploiter des éléments tels que :

  • les changements de couleur ou de pigmentation ;
  • les lésions visibles sur le corps ;
  • les anomalies morphologiques ;
  • les variations de texture ;
  • les signes extérieurs associés à certaines pathologies.

L’objectif est de transformer des images collectées dans les bassins ou les installations d’élevage en informations utiles pour aider à repérer les individus potentiellement malades.

Le fonctionnement général de SDA-Net

Un tel cadre repose généralement sur plusieurs étapes complémentaires. Les images sont d’abord collectées puis préparées afin de limiter l’influence du bruit, de l’éclairage ou de l’arrière-plan. Le modèle analyse ensuite les caractéristiques visuelles des crevettes et les compare aux profils présents dans les données d’apprentissage.

Cette approche permet d’envisager une évaluation plus rapide et plus homogène que l’inspection manuelle seule. Elle peut également contribuer à hiérarchiser les alertes et à orienter les contrôles réalisés par les éleveurs ou les spécialistes de la santé aquacole.

Un outil pour améliorer le suivi des élevages

L’intérêt de SDA-Net ne se limite pas à l’identification d’une anomalie sur une image. Intégrée à un système de surveillance, cette technologie pourrait aider à :

  1. détecter plus tôt les signes visibles d’une maladie ;
  2. surveiller régulièrement l’évolution de l’état des animaux ;
  3. réduire le temps consacré aux inspections manuelles ;
  4. faciliter la prise de décision dans les élevages ;
  5. limiter les risques de propagation d’une infection ;
  6. améliorer la traçabilité des observations sanitaires.

Une détection plus rapide peut permettre d’isoler les lots concernés, d’intensifier les analyses et de mettre en place des mesures correctives avant que la maladie ne se diffuse largement.

Les défis liés aux images aquacoles

L’application de la vision artificielle à l’aquaculture reste toutefois complexe. Les conditions d’acquisition peuvent varier considérablement selon la turbidité de l’eau, la luminosité, la densité des crevettes ou leur position dans l’image. Les animaux peuvent aussi se chevaucher, ce qui rend leur identification individuelle plus difficile.

La performance d’un modèle dépend également de la qualité et de la diversité des données utilisées pour son apprentissage. Des images provenant d’une seule ferme ou d’un environnement spécifique risquent de ne pas représenter toutes les situations rencontrées sur le terrain.

Une technologie d’aide, et non un remplacement de l’expertise

Même si un modèle comme SDA-Net peut accélérer l’analyse des images, il ne remplace pas les examens biologiques, les analyses de laboratoire ni l’avis d’un spécialiste. Les résultats produits par l’intelligence artificielle doivent être considérés comme une aide à la décision et vérifiés lorsqu’une intervention sanitaire est envisagée.

La mise en œuvre d’un tel outil nécessite également de prendre en compte la collecte des données, la protection des informations, la calibration des équipements et la formation des utilisateurs.

Vers une aquaculture plus préventive

Le développement de SDA-Net illustre l’évolution de l’aquaculture vers des systèmes de surveillance plus automatisés et préventifs. En combinant l’imagerie, l’apprentissage automatique et l’expertise des professionnels, les exploitations pourraient mieux suivre la santé des crevettes et réagir plus rapidement face aux premiers signes de maladie.

Ces solutions devront encore être évaluées dans des environnements variés afin de confirmer leur robustesse et leur capacité à fonctionner dans des conditions d’élevage réelles. Elles représentent néanmoins une piste prometteuse pour renforcer la biosécurité, réduire les pertes et améliorer la durabilité de la production aquacole.

Identifier les maladies du soja grâce à la fusion des données spectrales des deux faces des feuilles

Identifier les maladies du soja grâce à la fusion des données spectrales

La détection précoce des maladies constitue un enjeu majeur pour préserver les rendements du soja et limiter l’usage des traitements phytosanitaires. Une étude récente s’intéresse à une approche fondée sur l’analyse spectrale des feuilles, en combinant les informations recueillies sur leurs faces supérieure et inférieure.

Pourquoi surveiller les maladies du soja ?

Le soja peut être affecté par différentes maladies fongiques, bactériennes ou virales. Les premiers symptômes apparaissent parfois de manière discrète : changement de teinte, légère décoloration, modification de la texture ou apparition de petites lésions.

Une identification tardive peut favoriser la propagation de la maladie dans la parcelle. À l’inverse, un diagnostic rapide permet d’intervenir plus précisément, de réduire les pertes de production et d’optimiser les décisions agronomiques.

Les méthodes traditionnelles reposent principalement sur l’observation visuelle et l’expertise humaine. Elles restent utiles, mais elles peuvent être influencées par la luminosité, le stade de développement de la plante ou la ressemblance entre certains symptômes. Les techniques spectrales offrent une solution complémentaire capable de détecter des variations physiologiques parfois invisibles à l’œil nu.

Le principe de l’analyse spectrale

Chaque feuille réfléchit la lumière de façon différente selon son état physiologique. Une plante saine, une plante infectée ou une feuille présentant un stress peuvent ainsi produire des signatures spectrales distinctes.

L’analyse de ces signatures consiste à mesurer la réponse de la feuille sur différentes longueurs d’onde. Les données obtenues peuvent ensuite être traitées par des méthodes statistiques et des algorithmes d’apprentissage automatique afin de classer les échantillons selon leur état sanitaire.

Dans de nombreux travaux, seule la face supérieure de la feuille est analysée. Or, certaines maladies se manifestent plus tôt sur la face inférieure, tandis que d’autres modifient différemment les propriétés optiques des deux côtés. Cette asymétrie peut limiter la fiabilité d’un diagnostic fondé sur une seule surface.

Une approche fondée sur la fusion des deux faces

L’étude consacrée à l’identification des maladies du soja propose de combiner les données spectrales de la face supérieure et de la face inférieure des feuilles. Cette fusion vise à exploiter une information plus complète sur l’état de la plante.

Le processus peut être résumé en plusieurs étapes :

  1. collecte des feuilles de soja présentant différents états sanitaires ;
  2. acquisition des informations spectrales sur les deux faces ;
  3. prétraitement des signaux afin de réduire le bruit et les variations parasites ;
  4. extraction ou sélection des caractéristiques les plus pertinentes ;
  5. fusion des données issues des deux surfaces ;
  6. entraînement et évaluation de modèles de classification.

La fusion peut être réalisée à différents niveaux. Les données peuvent être réunies directement avant la modélisation, combinées après extraction des caractéristiques ou intégrées au stade de la décision finale. Le choix de la méthode influence la capacité du système à distinguer les différentes catégories de maladies.

Des informations complémentaires apportées par chaque face

Les deux faces d’une feuille ne présentent pas exactement les mêmes propriétés optiques. Leur structure, leur épaisseur, leur teneur en pigments et leur exposition aux agents pathogènes peuvent varier.

La face supérieure reçoit généralement davantage de lumière et peut révéler des modifications liées à la photosynthèse ou à la dégradation des pigments. La face inférieure, quant à elle, peut fournir des indices complémentaires concernant les échanges gazeux, la structure des tissus ou la présence de symptômes localisés.

En combinant ces deux sources, le modèle dispose d’un ensemble de variables plus riche. Il peut ainsi mieux différencier les maladies dont les symptômes visuels sont proches ou identifier des changements précoces avant l’apparition de signes clairement visibles.

Un apport potentiel de l’apprentissage automatique

L’analyse de données spectrales génère un grand nombre de variables. Les modèles d’apprentissage automatique sont donc particulièrement adaptés pour repérer les relations complexes entre les signatures lumineuses et l’état sanitaire des feuilles.

Avant l’apprentissage, les chercheurs doivent toutefois sélectionner les données les plus informatives et limiter les effets liés à l’éclairage, à l’humidité, à la position de la feuille ou aux différences entre les échantillons. Une préparation rigoureuse des données est indispensable pour éviter qu’un modèle ne mémorise simplement les conditions de mesure au lieu d’identifier réellement la maladie.

L’évaluation du système repose généralement sur plusieurs indicateurs, comme la précision globale, le taux de reconnaissance de chaque maladie, la sensibilité et la spécificité. La comparaison entre les données d’une seule face et les données fusionnées permet de déterminer l’intérêt réel de l’approche proposée.

Vers un diagnostic plus précoce et plus fiable

L’intérêt principal de la fusion spectrale réside dans l’amélioration potentielle de la robustesse du diagnostic. En exploitant les deux faces de la feuille, le système peut réduire le risque de passer à côté d’un signal important présent uniquement sur l’une des surfaces.

Cette approche pourrait également contribuer au développement d’outils de phénotypage automatisé, de systèmes d’inspection en serre ou de solutions de surveillance directement utilisables dans les champs. Associée à des caméras hyperspectrales, à des plateformes mobiles ou à des drones, elle pourrait permettre de suivre l’évolution sanitaire des cultures à grande échelle.

Des défis encore à relever

Malgré son potentiel, la méthode doit encore être validée dans des conditions variées. Les résultats obtenus en environnement contrôlé peuvent être influencés par plusieurs facteurs lorsqu’ils sont transposés au champ :

  • diversité des variétés de soja ;
  • stades de développement des plantes ;
  • intensité et ancienneté de l’infection ;
  • conditions météorologiques ;
  • variations de luminosité ;
  • présence simultanée de plusieurs stress ;
  • différences entre les capteurs et les dispositifs d’acquisition.

La constitution de bases de données plus importantes et plus diversifiées sera donc essentielle. Il faudra également rendre les modèles suffisamment rapides, abordables et simples à utiliser pour faciliter leur adoption par les agriculteurs et les techniciens.

Une piste prometteuse pour l’agriculture de précision

L’identification des maladies du soja à partir de données spectrales fusionnées illustre le rôle croissant des technologies d’intelligence artificielle dans l’agriculture de précision. L’analyse conjointe des faces supérieure et inférieure des feuilles apporte une vision plus complète que l’observation d’une seule surface.

Cette stratégie ne remplace pas nécessairement le diagnostic agronomique, mais elle peut servir d’outil d’alerte et d’aide à la décision. À terme, l’intégration de ces méthodes dans des systèmes automatisés pourrait favoriser une détection plus rapide, des interventions mieux ciblées et une utilisation plus raisonnée des intrants agricoles.

Modèles de prévision des maladies des plantes : avancées et applications

Modèles de prévision des maladies des plantes : avancées et applications

La prévision des maladies végétales occupe une place croissante dans l’agriculture moderne. En permettant d’anticiper l’apparition ou la progression d’une maladie, les modèles de prévision aident les producteurs à intervenir au moment le plus pertinent, tout en limitant les traitements inutiles et les pertes de rendement.

Les progrès récents de la modélisation, des capteurs, de l’intelligence artificielle et de l’agriculture numérique ouvrent de nouvelles perspectives. Les systèmes de prévision ne se limitent plus à quelques règles fondées sur la température et l’humidité : ils intègrent désormais de nombreuses données afin de produire des recommandations plus localisées et plus réactives.

Pourquoi prévoir les maladies des cultures ?

Les maladies végétales peuvent réduire fortement la productivité et la qualité des récoltes. Leur développement dépend de l’interaction entre plusieurs facteurs :

  • la présence d’un agent pathogène ou d’une source d’inoculum ;
  • la sensibilité de la plante et son stade de développement ;
  • la température, l’humidité et la durée d’humectation du feuillage ;
  • les pratiques culturales et les conditions de la parcelle ;
  • les conditions météorologiques à venir.

Une stratégie fondée sur la seule observation visuelle intervient parfois trop tard. À l’inverse, des traitements systématiques peuvent entraîner une hausse des coûts, favoriser l’apparition de résistances et accroître l’impact environnemental. La prévision vise donc à mieux synchroniser la surveillance et l’intervention.

Les principaux types de modèles

Les modèles fondés sur les conditions météorologiques

Les premiers systèmes de prévision reposaient principalement sur des seuils météorologiques. Ils analysaient, par exemple, la température, l’humidité relative, les précipitations ou la durée d’humectation des feuilles afin d’identifier une période favorable à l’infection.

Ces modèles restent utiles pour de nombreuses maladies, notamment lorsque les relations entre le climat et le cycle du pathogène sont bien établies. Leur principal avantage réside dans leur simplicité et leur facilité d’intégration dans les outils d’aide à la décision.

Les modèles mécanistes

Les modèles mécanistes cherchent à représenter les différentes étapes du cycle de la maladie : germination, infection, incubation, sporulation et dissémination. Ils s’appuient sur les connaissances biologiques relatives à la plante et à l’agent pathogène.

Plus complexes, ils peuvent fournir une interprétation plus précise des risques. Ils nécessitent toutefois des données fiables et une calibration adaptée aux variétés, aux régions et aux systèmes de culture concernés.

Les modèles statistiques et empiriques

Les modèles statistiques établissent des relations entre l’apparition d’une maladie et un ensemble de variables observées. Ils peuvent être construits à partir de données historiques issues de parcelles, de stations météorologiques ou de réseaux de surveillance.

Ils sont particulièrement intéressants pour identifier les facteurs les plus associés au risque sanitaire. Cependant, leur performance peut diminuer lorsque les conditions climatiques ou les pratiques agricoles s’éloignent de celles utilisées pour leur conception.

L’intelligence artificielle et l’apprentissage automatique

L’apprentissage automatique permet d’analyser de grandes quantités de données et de détecter des relations difficiles à identifier avec des méthodes classiques. Les algorithmes peuvent exploiter simultanément des données météorologiques, des images de cultures, des informations satellitaires, des historiques de traitements et des observations de terrain.

Les réseaux neuronaux et les méthodes de classification sont notamment utilisés pour :

  • détecter des symptômes sur des images de feuilles ou de plantes ;
  • estimer la probabilité d’apparition d’une maladie ;
  • cartographier les zones à risque ;
  • prévoir l’évolution de la gravité d’une infection ;
  • proposer des alertes adaptées à chaque parcelle.

Ces approches offrent des résultats prometteurs, mais elles dépendent fortement de la qualité, de la diversité et de la représentativité des données d’entraînement.

L’apport des technologies numériques

Les systèmes actuels combinent plusieurs sources d’information. Les stations météorologiques connectées fournissent des mesures locales, tandis que les capteurs installés dans les parcelles suivent l’humidité du sol, la température ou l’état du couvert végétal.

Les drones et les satellites complètent ces observations en produisant des images régulières à différentes échelles. Ces données peuvent révéler des variations de vigueur ou de couleur avant même que les symptômes soient clairement visibles à l’œil nu.

Les plateformes numériques regroupent ensuite les informations dans des tableaux de bord accessibles aux agriculteurs et aux conseillers. Les alertes peuvent être transmises par application mobile, courrier électronique ou logiciel de gestion de l’exploitation.

Des applications dans de nombreuses cultures

Les modèles de prévision sont utilisés ou étudiés pour un large éventail de cultures, notamment :

  • les céréales, pour surveiller des maladies foliaires et des maladies des épis ;
  • la vigne, où le mildiou et l’oïdium nécessitent une surveillance régulière ;
  • les arbres fruitiers, exposés à différentes infections au cours de la saison ;
  • les cultures maraîchères, souvent sensibles aux conditions humides ;
  • les oléagineux et les légumineuses, dont la protection peut être optimisée grâce aux alertes locales.

Dans chacun de ces secteurs, les modèles doivent être adaptés au cycle de la culture, aux variétés cultivées, au climat et aux pratiques de production.

Un outil pour une protection plus durable

L’un des principaux intérêts de la prévision est de contribuer à une utilisation plus raisonnée des produits phytosanitaires. En intervenant lorsque le risque est suffisamment élevé, le producteur peut éviter certaines applications préventives qui ne seraient pas nécessaires.

Cette approche peut générer plusieurs bénéfices :

  • une réduction du nombre de traitements ;
  • une diminution des coûts d’intervention ;
  • une limitation de l’exposition des organismes non ciblés ;
  • une meilleure gestion du risque de résistance ;
  • une utilisation plus efficace des solutions de biocontrôle et des traitements curatifs.

La prévision ne remplace toutefois pas l’expertise agronomique. Elle constitue un outil d’aide à la décision qui doit être associé à la surveillance des parcelles et à une stratégie intégrée de protection des cultures.

Les limites à surmonter

Malgré les progrès réalisés, plusieurs obstacles freinent encore le déploiement généralisé de ces outils. La première difficulté concerne la disponibilité des données. Les observations doivent être suffisamment nombreuses, précises et représentatives de situations agricoles variées.

La transférabilité des modèles constitue un autre enjeu. Un modèle performant dans une région donnée peut perdre en fiabilité dans un autre contexte climatique ou sur une variété différente. Une actualisation régulière et une validation locale sont donc indispensables.

L’interprétabilité des modèles d’intelligence artificielle est également importante. Les utilisateurs doivent comprendre pourquoi une alerte est déclenchée et quelles données ont conduit à cette recommandation. Sans cette transparence, l’adoption par les professionnels peut rester limitée.

Enfin, l’accès aux technologies, le coût des équipements, la qualité de la connectivité et la formation des utilisateurs doivent être pris en compte, en particulier dans les exploitations de petite taille.

Vers des systèmes de prévision intégrés

L’avenir des modèles de prévision repose probablement sur la combinaison de plusieurs approches. Les connaissances biologiques des modèles mécanistes peuvent être associées à la puissance d’analyse de l’intelligence artificielle et aux données fournies par les capteurs et l’imagerie.

Les systèmes les plus performants pourraient également intégrer des données en temps réel, des prévisions météorologiques à haute résolution et des informations sur les interventions déjà réalisées. Ils fourniront alors des recommandations évolutives, adaptées à la situation précise de chaque parcelle.

Cette évolution s’inscrit dans le développement de l’agriculture de précision. En transformant des données hétérogènes en informations directement exploitables, les outils de prévision peuvent aider les agriculteurs à gagner en réactivité tout en améliorant l’efficacité et la durabilité de la protection des cultures.

Conclusion

Les modèles de prévision des maladies végétales connaissent une transformation importante. Des systèmes fondés sur quelques variables météorologiques, ils évoluent vers des plateformes intégrant biologie, données de terrain, télédétection et intelligence artificielle.

Leur potentiel est considérable : mieux cibler les interventions, réduire les intrants et limiter les pertes liées aux maladies. Pour atteindre ces objectifs, leur développement doit toutefois s’accompagner d’une validation rigoureuse, d’une adaptation aux réalités locales et d’une utilisation complémentaire de l’observation agronomique.

À terme, la combinaison de modèles fiables, de données accessibles et de conseils adaptés pourrait devenir un élément central d’une protection intégrée des cultures plus précise et plus respectueuse de l’environnement.

Un benchmark annoté pour détecter la sclérotiniose et améliorer la gestion de la moisissure blanche

Un benchmark annoté pour détecter la sclérotiniose et améliorer la gestion de la moisissure blanche

La moisissure blanche, également appelée sclérotiniose, figure parmi les maladies les plus préoccupantes pour de nombreuses cultures agricoles. Provoquée par le champignon Sclerotinia sclerotiorum, elle peut entraîner des pertes importantes lorsque les symptômes sont détectés trop tard ou que les interventions sont insuffisamment ciblées.

Dans ce contexte, l’article « Large-scale annotated benchmark for Sclerotinia sclerotiorum object detection in white mold management » présente une ressource destinée à accélérer le développement d’outils d’intelligence artificielle pour la surveillance de cette maladie.

Une base de référence pour l’analyse automatisée des images

L’étude met à disposition un benchmark de grande ampleur composé d’images annotées pour l’entraînement et l’évaluation de modèles de détection d’objets. L’objectif est de permettre aux algorithmes d’identifier plus efficacement les signes associés à la présence de Sclerotinia sclerotiorum et aux infections de moisissure blanche.

Contrairement à une simple collection d’images, un benchmark annoté fournit des indications précises sur les zones d’intérêt visibles dans chaque document. Ces annotations servent de référence pour comparer les performances des modèles et mesurer leur capacité à localiser les symptômes dans des conditions variées.

Pourquoi la détection de la moisissure blanche est importante

La sclérotiniose peut toucher plusieurs cultures, notamment le soja, le colza, le tournesol, les légumineuses et certains légumes. Le champignon se développe généralement dans des conditions humides et peut se propager rapidement au sein d’une parcelle.

Une détection précoce peut contribuer à :

  • repérer les foyers d’infection avant leur extension ;
  • mieux cibler les observations sur le terrain ;
  • améliorer le déclenchement des traitements ou des mesures de prévention ;
  • limiter les applications uniformes et parfois inutiles de produits phytosanitaires ;
  • suivre l’évolution de la maladie au fil du temps.

L’automatisation de cette surveillance pourrait ainsi compléter les inspections réalisées par les agriculteurs, les conseillers agricoles et les agronomes.

Un outil pour entraîner les modèles de vision par ordinateur

Les méthodes de vision par ordinateur sont de plus en plus utilisées en agriculture de précision. Elles peuvent analyser des images capturées par des smartphones, des caméras embarquées, des robots ou des drones afin de détecter des anomalies sur les plantes.

Le jeu de données présenté dans cette publication peut servir à plusieurs étapes du développement d’un modèle :

  1. L’entraînement, pour apprendre au système à reconnaître les caractéristiques visuelles de la maladie.
  2. La validation, afin d’ajuster les paramètres du modèle et de limiter les erreurs.
  3. L’évaluation, pour comparer différents algorithmes dans un cadre commun.
  4. La reproductibilité, en permettant à d’autres équipes de tester leurs approches sur une référence partagée.

Cette standardisation est essentielle, car les résultats obtenus par deux modèles ne peuvent être comparés correctement que s’ils sont évalués sur des données similaires et selon des critères cohérents.

Des annotations essentielles à la qualité des résultats

La performance d’un système de détection dépend fortement de la qualité des annotations. Les images doivent être suffisamment représentatives des situations rencontrées sur le terrain : différents stades d’infection, niveaux de gravité, arrière-plans, conditions d’éclairage et variations entre les cultures.

Des annotations précises permettent notamment de distinguer la présence de symptômes d’autres éléments visuellement proches. Elles contribuent aussi à réduire les faux positifs, qui peuvent conduire à des interventions inutiles, ainsi que les faux négatifs, susceptibles de laisser une infection progresser sans être repérée.

Le benchmark constitue donc autant une ressource pour l’apprentissage automatique qu’un support pour l’analyse des limites actuelles de la détection automatisée.

Vers une gestion plus ciblée des cultures

L’un des principaux intérêts de cette ressource réside dans ses applications potentielles pour l’agriculture de précision. Un modèle fiable pourrait être intégré à une plateforme d’aide à la décision afin de fournir une cartographie des zones affectées ou de hiérarchiser les parcelles à inspecter.

À terme, ces outils pourraient contribuer à une gestion plus localisée de la maladie. Les interventions seraient alors fondées sur l’état réel des cultures plutôt que sur une application uniforme à l’ensemble d’une parcelle.

Cette approche doit toutefois rester complémentaire de l’expertise humaine. Une image ne suffit pas toujours à confirmer la présence du pathogène : les symptômes peuvent varier selon la culture, le stade de développement de la plante, les conditions météorologiques ou la présence d’autres maladies.

Des perspectives pour la recherche et le terrain

La publication fournit une base commune pour les chercheurs travaillant sur la détection des maladies végétales. Elle peut également favoriser le développement de modèles plus robustes, capables de fonctionner dans des environnements agricoles réels et non uniquement dans des conditions contrôlées.

Les travaux futurs pourront notamment porter sur :

  • l’amélioration de la détection dans des images complexes ;
  • la reconnaissance des différents stades de la maladie ;
  • l’adaptation des modèles à plusieurs espèces cultivées ;
  • l’utilisation d’images prises par drone ou par caméra mobile ;
  • l’intégration de données météorologiques et agronomiques ;
  • la conception d’outils utilisables directement par les producteurs.

Une étape vers une surveillance phytosanitaire plus intelligente

En rassemblant des images annotées et en proposant une référence commune pour l’évaluation des modèles, ce benchmark contribue à structurer la recherche sur la détection de Sclerotinia sclerotiorum. Il offre un point de départ pour concevoir des solutions capables d’identifier plus rapidement la moisissure blanche et d’appuyer les décisions de gestion des cultures.

L’enjeu sera désormais de transformer ces performances expérimentales en outils fiables, accessibles et suffisamment robustes pour répondre à la diversité des conditions agricoles. Utilisée avec les observations de terrain et les connaissances agronomiques, l’intelligence artificielle pourrait ainsi renforcer la prévention et la maîtrise de la sclérotiniose.

Un cadre préliminaire d’IA pour détecter les risques fongiques et les mycotoxines par imagerie hyperspectrale

L’intelligence artificielle au service de la détection des risques fongiques et des mycotoxines

La sécurité sanitaire des aliments repose en grande partie sur la capacité à détecter rapidement les contaminations fongiques et les mycotoxines. Ces substances, produites par certaines moisissures, peuvent apparaître dans les céréales, les fruits secs, les épices, les aliments pour animaux et de nombreuses autres matières premières. Leur détection reste toutefois complexe, car les contaminations peuvent être hétérogènes, peu visibles à l’œil nu et parfois présentes à des concentrations difficiles à mesurer.

Dans ce contexte, l’article publié dans la revue Foods propose un cadre préliminaire fondé sur l’intelligence artificielle et les systèmes d’imagerie hyperspectrale. L’objectif est de mieux exploiter les informations spectrales et visuelles recueillies au cours du contrôle des denrées alimentaires.

Pourquoi les méthodes traditionnelles montrent leurs limites

Les analyses classiques des mycotoxines reposent généralement sur des méthodes de laboratoire très précises, mais qui nécessitent du temps, des équipements spécialisés et une préparation des échantillons. Elles sont indispensables pour confirmer une contamination, mais leur utilisation systématique sur de grands volumes peut être coûteuse et difficile à intégrer dans des chaînes de production rapides.

L’inspection visuelle présente, quant à elle, plusieurs limites :

  • certaines moisissures sont invisibles aux premiers stades de développement ;
  • l’apparence extérieure d’un produit ne révèle pas toujours une contamination interne ;
  • l’évaluation humaine peut varier selon l’opérateur ;
  • les contrôles manuels sont difficiles à standardiser à grande échelle.

Les technologies d’imagerie hyperspectrale peuvent contribuer à répondre à ces difficultés en associant une image de l’échantillon à des informations liées à sa signature spectrale.

Le principe de l’imagerie hyperspectrale

Contrairement à une caméra classique, un système hyperspectral enregistre les propriétés de la lumière réfléchie ou absorbée par un produit sur un grand nombre de longueurs d’onde. Chaque pixel contient ainsi des données permettant de caractériser à la fois la forme, la couleur et certaines propriétés physiques ou chimiques de l’échantillon.

Cette richesse d’information peut aider à différencier :

  • les produits sains et les produits présentant des signes de développement fongique ;
  • différentes espèces ou catégories de moisissures ;
  • des zones contaminées et non contaminées au sein d’un même lot ;
  • des modifications invisibles lors d’une inspection conventionnelle.

L’imagerie hyperspectrale ne mesure pas nécessairement directement chaque mycotoxine. Elle peut cependant repérer des changements associés à la croissance fongique ou à l’altération du produit. Ces signaux peuvent ensuite être analysés par des modèles d’intelligence artificielle afin d’estimer le niveau de risque.

Le rôle de l’intelligence artificielle

Le volume et la complexité des données hyperspectrales rendent difficile une interprétation exclusivement humaine. Les algorithmes d’apprentissage automatique et d’apprentissage profond peuvent identifier des relations entre les signatures spectrales, les caractéristiques visuelles et les résultats d’analyses de référence.

Un système d’IA destiné à la gestion des risques fongiques pourrait notamment être entraîné pour :

  1. détecter les anomalies dans les images ou les spectres ;
  2. classer les échantillons selon leur niveau de risque ;
  3. localiser les zones suspectes sur un produit ou dans un lot ;
  4. estimer la probabilité d’une contamination ;
  5. orienter les échantillons vers une analyse de laboratoire lorsque cela est nécessaire.

Cette approche permettrait de combiner un dépistage rapide et non destructif avec des méthodes analytiques de confirmation plus ciblées.

Un cadre en plusieurs étapes

Le cadre préliminaire présenté s’inscrit dans une logique de chaîne de décision. Il ne se limite pas à la création d’un modèle prédictif : il cherche à organiser l’ensemble du processus, depuis l’acquisition des données jusqu’à l’utilisation des résultats dans la gestion de la sécurité alimentaire.

1. Acquisition et préparation des données

La première étape consiste à recueillir des images hyperspectrales dans des conditions contrôlées. La qualité des données dépend notamment de l’éclairage, de la position des échantillons, de l’humidité, de la variété analysée et de l’état de surface du produit.

Les données doivent ensuite être prétraitées afin de réduire le bruit, de corriger les variations d’éclairage et de faciliter la comparaison entre les échantillons.

2. Constitution de bases de données fiables

Un modèle d’IA n’est pertinent que s’il est entraîné sur des données représentatives. Les bases d’apprentissage doivent donc inclure des produits sains, des produits contaminés à différents niveaux et des situations présentant des variations naturelles.

Les informations spectrales doivent être associées à des résultats de référence obtenus par des méthodes analytiques reconnues. Cette étape est essentielle pour éviter qu’un algorithme apprenne à reconnaître uniquement une variété, un site de production ou une condition expérimentale particulière.

3. Développement et validation des modèles

Différents modèles peuvent être utilisés selon l’objectif recherché : classification, détection d’anomalies, régression ou segmentation des zones contaminées. La validation doit être réalisée sur des données indépendantes de celles utilisées pour l’entraînement.

Les performances ne doivent pas être évaluées uniquement à partir de la précision globale. Il est également important de mesurer les faux négatifs, c’est-à-dire les produits contaminés que le système ne détecte pas. Dans le domaine de la sécurité alimentaire, ce type d’erreur peut avoir des conséquences particulièrement importantes.

4. Intégration dans les opérations de contrôle

Pour être utile, un outil d’IA doit pouvoir s’intégrer aux pratiques des laboratoires, des sites de transformation et des dispositifs de surveillance. Les résultats doivent être compréhensibles par les opérateurs et associés à des seuils d’action clairement définis.

Un système pourrait, par exemple, classer les lots en plusieurs catégories :

  • risque faible : poursuite du processus habituel ;
  • risque intermédiaire : contrôle complémentaire ou échantillonnage renforcé ;
  • risque élevé : mise à l’écart du lot et analyse confirmatoire en laboratoire.

Les avantages attendus

L’association de l’imagerie hyperspectrale et de l’IA présente plusieurs avantages potentiels :

  • contrôle rapide de grands volumes d’échantillons ;
  • analyse non destructive ;
  • réduction du nombre d’analyses de laboratoire nécessaires au dépistage ;
  • meilleure détection des hétérogénéités au sein d’un lot ;
  • suivi plus précoce de la contamination ;
  • amélioration de la traçabilité et de la prise de décision.

Cette technologie pourrait être utilisée à différents niveaux de la chaîne alimentaire, depuis la réception des matières premières jusqu’au contrôle des produits finis. Elle pourrait également contribuer à une surveillance plus régulière dans les environnements où les conditions climatiques favorisent le développement des champignons.

Des limites à prendre en compte

Le cadre proposé reste préliminaire et ne constitue pas, à lui seul, une solution immédiatement applicable à toutes les filières. Plusieurs obstacles doivent encore être traités.

Variabilité des produits et des conditions de mesure

Les signatures spectrales peuvent varier en fonction de la variété, de l’origine géographique, du degré de maturité, de l’humidité, du stockage et du procédé de transformation. Un modèle performant dans un laboratoire peut donc perdre en fiabilité dans un autre environnement.

Difficulté de relier les signaux aux mycotoxines

La présence d’une moisissure ne signifie pas systématiquement qu’une mycotoxine est présente, et l’absence de signes visibles ne garantit pas l’absence de toxines. Les modèles doivent par conséquent être entraînés et interprétés avec prudence, en s’appuyant sur des analyses chimiques de référence.

Besoin de données diversifiées

Les bases de données doivent couvrir une grande variété de situations réelles. Elles doivent aussi être régulièrement enrichies pour tenir compte de nouveaux produits, de nouvelles conditions de production et de l’évolution des équipements.

Explicabilité et confiance

Dans un contexte réglementaire et sanitaire, les opérateurs doivent pouvoir comprendre pourquoi un lot est considéré comme suspect. Les méthodes d’IA explicables peuvent faciliter l’acceptation des outils et aider à identifier les erreurs ou les biais du modèle.

Validation réglementaire

Un système de dépistage automatisé ne peut pas remplacer sans validation les méthodes officielles de confirmation. Son rôle doit être défini avec précision afin de garantir la conformité des décisions prises à partir de ses résultats.

Vers une approche hybride de la sécurité alimentaire

L’intérêt principal du cadre proposé réside dans l’articulation entre plusieurs technologies plutôt que dans le remplacement des méthodes existantes. L’imagerie hyperspectrale et l’IA peuvent assurer un premier niveau de tri rapide, tandis que les analyses de laboratoire permettent de confirmer la présence et la concentration des mycotoxines.

Cette approche hybride pourrait améliorer l’efficacité des contrôles en concentrant les ressources analytiques sur les échantillons les plus à risque. Elle favoriserait également une gestion plus préventive, fondée sur la surveillance continue plutôt que sur des contrôles ponctuels.

Conclusion

L’utilisation conjointe de l’intelligence artificielle et de l’imagerie hyperspectrale ouvre des perspectives intéressantes pour la détection des moisissures et la gestion des risques liés aux mycotoxines. En permettant un dépistage rapide, non destructif et potentiellement automatisé, cette technologie pourrait renforcer les dispositifs de contrôle tout au long de la chaîne alimentaire.

Son déploiement nécessitera toutefois des bases de données robustes, des protocoles harmonisés, une validation sur le terrain et un lien permanent avec les méthodes analytiques de référence. Le cadre préliminaire présenté constitue ainsi une étape vers des systèmes de surveillance plus intelligents, capables d’aider les professionnels à prendre des décisions rapides et mieux documentées.

Tri intelligent des tubercules de pomme de terre et des impuretés minérales via deep learning : développement et évaluation d’un système automatisé

Tri intelligent des tubercules de pomme de terre et impuretés minérales par deep learning : développement d’un système innovant et évaluation

Introduction

La filière agroalimentaire accorde une importance cruciale à la qualité de ses produits, en particulier dans le traitement post-récolte des pommes de terre. Un tri fiable permettant de distinguer efficacement les tubercules des impuretés minérales tel que pierres, mottes ou autres débris s’avère indispensable tant pour la sécurité alimentaire que pour l’optimisation des chaînes industrielles. Récemment, le recours à l’intelligence artificielle, et notamment au deep learning, a ouvert la voie à de nouveaux dispositifs de tri automatique haute performance.

Cet article dévoile la conception, la mise en œuvre et l’évaluation d’un système intelligent de tri automatisé s’appuyant sur des algorithmes de deep learning pour séparer les pommes de terre des impuretés minérales. Il met en lumière les enjeux techniques, les choix méthodologiques et les résultats obtenus à travers des expérimentations rigoureuses.

Développement du système de tri automatique

Architecture matérielle et logicielle

Le système développé comporte plusieurs modules interconnectés :

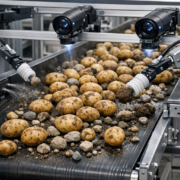
  • Un convoyeur motorisé assurant l’acheminement et la dispersion uniforme du flux mélangé (tubercules/impuretés).
  • Un module d’acquisition d’images équipé de caméras industrielles à haute résolution, capturant les lots en temps réel.
  • Une unité de traitement embarquant des algorithmes de deep learning pré-entraînés spécialisés dans la reconnaissance et la classification d’objets agroalimentaires.
  • Des actionneurs mécaniques assurant la séparation physique des éléments reconnus entre tubercules triés et déchets minéraux.

Traitement numérique et algorithmes de classification

Le cœur du dispositif repose sur l’entraînement de réseaux de neurones convolutifs (CNN) profonds, structurés autour d’une architecture de type ResNet-50 pour l’extraction de caractéristiques visuelles complexes. Ce modèle a été optimisé sur une base de données de milliers d’images annotées, couvrant l’ensemble des variations de morphologie, de texture et de couleur propres aux pommes de terre et aux diverses impuretés minérales.

Un pipeline de prétraitement implique :

  • Correction des variations d’éclairage,
  • Normalisation des pixels,
  • Suppression du bruit visuel.

Cela permet d’alimenter le modèle en entrées homogènes, améliorant sensiblement la robustesse de la classification.

Évaluation expérimentale du système

Base de données et protocole d'expérimentation

Pour évaluer le système, une vaste collection d’échantillons a été constituée, comprenant un panel représentatif de tubercules et de différentes catégories d’impuretés (blocs de sol, pierres naturelles, morceaux de bois, etc.).
La performance du dispositif a été analysée selon plusieurs métriques :

  • Taux de reconnaissance (accuracy) pour chaque type d’objet,
  • Précision de la séparation (souvent mesurée par la F1-score et l’IoU),
  • Rapidité de traitement par lot,
  • Résilience en conditions industrielles réelles (environnement poussiéreux, variations de luminosité, vitesse élevée du tapis).

Résultats obtenus et discussion

Les tests ont mis en évidence une capacité de détection remarquable, avec une précision globale dépassant 98% pour la distinction pomme de terre/impuretés, toutes catégories confondues. Le système démontre une grande stabilité opérationnelle, minimisant aussi bien les faux positifs (pommes de terre écartées à tort) que les faux négatifs (impuretés non éliminées).

La rapidité du dispositif (jusqu’à 30 images par seconde en temps réel) rend l’application parfaitement compatible avec les cadences industrielles modernes. Par ailleurs, la polyvalence du modèle permet d’adapter la solution à d’autres types d’impuretés ou de produits agricoles moyennant une phase de ré-entraînement supervisé.

Avantages et perspectives d’application

Bénéfices industriels

Ce système assure :

  • Une amélioration significative de la qualité des lots,
  • Une réduction des coûts liés au tri manuel,
  • Une sécurité sanitaire accrue grâce à un tri exhaustif,
  • Une optimisation des processus industriels avec moins de pertes et d’arrêts non planifiés.

Prolongements techniques

Les auteurs soulignent le potentiel du deep learning pour l’automatisation avancée dans l’agroalimentaire. Déploiements futurs envisagent :

  • Des modèles multi-classes capables de différencier plusieurs types de défauts et objets,
  • L'intégration de la vision hyperspectrale pour mieux discriminer les matières,
  • L’exploitation de l’analyse en temps réel pour le pilotage automatique des lignes de tri.

Conclusion

Le tri intelligent des pommes de terre et impuretés minérales par deep learning offre une avancée déterminante pour l’industrie agroalimentaire, associant précision, fiabilité et flexibilité opérationnelle. Ce système, validé expérimentalement, pose les bases de nouvelles générations de solutions automatisées portées par l’intelligence artificielle dans l’agriculture connectée.

Source : https://www.mdpi.com/2304-8158/15/12/2070

L’intelligence artificielle révolutionne la sécurité alimentaire par l’optimisation des immunoessais

L’intelligence artificielle révolutionne la sécurité alimentaire par les immunoessais : technologies et applications

Introduction

La sécurité alimentaire, pilier de la santé publique, dépend étroitement de méthodes analytiques performantes pour la détection des agents pathogènes, contaminants chimiques et allergènes. Les immunoessais, tels que les tests ELISA et les immunocapteurs, sont devenus des outils de référence pour leur rapidité, spécificité et sensibilité. Toutefois, la complexité croissante des matrices alimentaires et l’accroissement du volume de données générées imposent une évolution des méthodes analytiques. L’intelligence artificielle (IA), et notamment le machine learning, s’impose ainsi comme catalyseur de la transition vers une surveillance alimentaire plus réactive, précise et automatisée.

Les fondements des immunoessais dans la sécurité alimentaire

Les immunoessais reposent sur les interactions antigène-anticorps détectant une grande diversité d’analytes, tels que résidus de pesticides, mycotoxines ou toxines bactériennes dans les denrées alimentaires. Leur adoption s’est élargie grâce à :

  • Rapidité de détection : résultats en temps quasi-réel
  • Spécificité élevée grâce à l’utilisation d’anticorps hautement sélectifs
  • Adaptabilité à divers formats (plaque, bandelette, microfluide)

Cependant, face à la diversité des contaminants et à la variabilité des matrices alimentaires, la sensibilité et la reproductibilité des tests constituent des défis majeurs, exacerbés par l'augmentation massive des exigences réglementaires.

L’irruption de l’IA dans l’optimisation des immunoessais

L’intégration de l’intelligence artificielle permet d’optimiser plusieurs étapes critiques des immunoessais :

Prétraitement et analyse des images

Les immunoessais colorimétriques ou à fluorescence produisent des signaux souvent analysés visuellement ou par capture d’image. Les algorithmes d’IA, tels que les réseaux neuronaux convolutifs, automatisent l’interprétation des résultats, réduisant l’erreur humaine et améliorant la répétabilité. Des applications concrètes incluent l’exploitation d’appareils mobiles pour analyser les bandelettes de test via des applications dédiées.

Modélisation et calibration des réponses analytiques

Le machine learning peut modéliser la réponse complexe d'un immunoessai en fonction des variables d’environnement, des lots d’anticorps ou des différences d’échantillons. Les techniques telles que les forêts aléatoires et les SVM (machines à vecteurs de support) permettent de prédire la concentration des cibles avec plus de robustesse qu’un simple ajustement linéaire conventionnel.

Gestion et interprétation de grands volumes de données

Avec la multiplication des points de contrôle environnemental et des campagnes de screening, la quantité de données générées explose. L’IA facilite l’intégration, le stockage sécurisé et surtout l’extraction d’informations pertinentes pour :

  • Détecter rapidement de nouveaux schémas de contamination
  • Identifier des corrélations insoupçonnées entre variables
  • Alimenter les systèmes d’alerte précoce collaboratifs (partage des données au niveau mondial)

Applications emblématiques de l’IA en immunoessais alimentaires

Détection d’allergènes et de contaminants chimiques

Des solutions d’IA déployées sur smartphone permettent aujourd’hui d’obtenir et d’interpréter instantanément le résultat d’un test d’allergènes sur un produit alimentaire, minimisant le risque d’exposition accidentelle. L’IA détecte ainsi des faibles différentiations de nuances colorimétriques ou de fluorescence indétectables à l’œil nu.

Identification rapide d’agents pathogènes

En combinant microfluidique et IA, il est désormais possible de réaliser des tests multiplexés pour plusieurs pathogènes en moins d’une heure. Les résultats, centralisés dans des bases de données sécurisées, alimentent de puissants algorithmes d’analyse prédictive.

Qualité, traçabilité et conformité réglementaire

Les systèmes automatisés, appuyés par le deep learning, évaluent en continu la conformité des lots de production. Ils détectent, par l’analyse de motifs ou l’apprentissage non supervisé, des anomalies subtiles qui pourraient échapper aux contrôles conventionnels.

Défis et perspectives pour une adoption à grande échelle

Bien que l’adoption de l’IA dans les immunoessais offre d’immenses perspectives, des obstacles demeurent :

  • Qualité des ensembles de données d’entraînement, qui doivent être représentatives et exemptes de biais.
  • Sécurisation et confidentialité des données alimentaires sensibles
  • Intégration transparente avec les systèmes informatiques existants dans l’industrie agroalimentaire

À l’avenir, le développement d’algorithmes auto-adaptatifs, la miniaturisation accrue des plateformes de détection et l’avènement de bases de données mondiales pourraient transformer la surveillance alimentaire en un processus prédictif, proactif et entièrement automatisé.

Conclusion

L’intelligence artificielle joue déjà un rôle déterminant dans la redéfinition des immunoessais alimentaires. Par l’automatisation de l’analyse, la gestion de la donnée et l’amélioration des performances analytiques, l’IA accélère le passage d’une méthodologie descriptive à une stratégie dynamique de sécurité alimentaire. Cette synergie entre biotechnologie et intelligence artificielle annonce une nouvelle ère pour la surveillance et le contrôle qualité tout au long de la chaîne alimentaire.

Source : https://www.sciencedirect.com/science/article/abs/pii/S2214799326000664