Deep Learning pour la détection des maladies du caféier : Enjeux pour la traçabilité dans l’e-commerce agricole
Deep Learning et détection des maladies du caféier : Défis et perspectives pour la traçabilité de la qualité dans l’e-commerce agricole
Introduction
La culture du café, essentielle à l’économie mondiale et surtout cruciale pour de nombreux pays producteurs, fait face à des risques sanitaires majeurs dus aux maladies fongiques et bactériennes touchant les feuilles. Ces maladies compromettent aussi bien la quantité que la qualité de la récolte. L’émergence de l’e-commerce agricole, dont les plateformes numériques facilitent le commerce du café, accentue les besoins en traçabilité et en maintien de la qualité. L’intégration du deep learning dans la détection précoce des maladies du caféier représente une avancée techno-scientifique inédite, apportant de nouvelles réponses à ces défis complexes.
Les enjeux de la détection des maladies du caféier
La détection manuelle traditionnelle, longtemps pratiquée dans les plantations, se révèle chronophage, peu fiable et sensible à l’expertise humaine. Face à la variété des symptômes foliaires et aux conditions de culture mouvantes, la précision du diagnostic repose fortement sur la compétence de chaque observateur. Adoptant des modèles d’apprentissage profond, les chercheurs cherchent à automatiser ce processus, tendre vers l’universalité des diagnostics et fiabiliser la chaîne de valeur.
Maladies principales du caféier
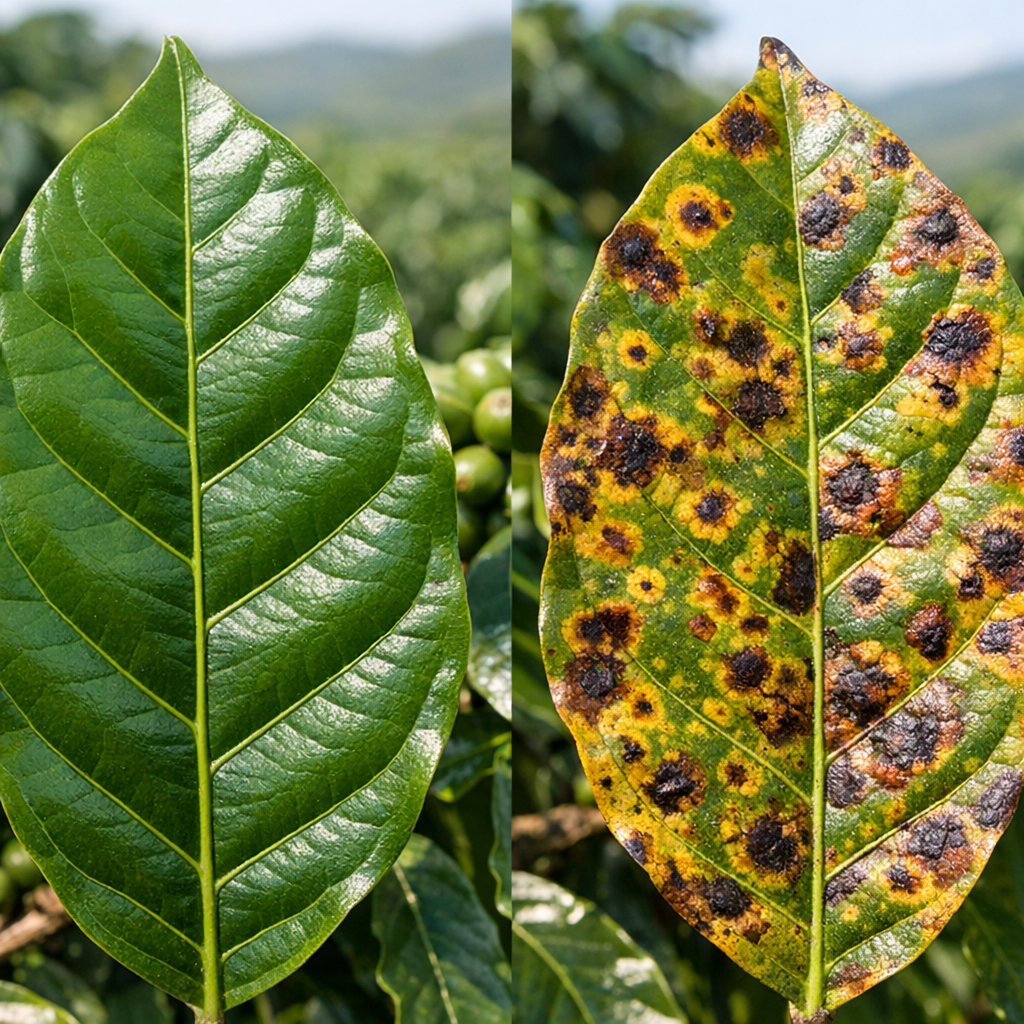
- Rouille (Hemileia vastatrix)
- Cercosporiose (Cercospora coffeicola)
- Taches bactériennes (Pseudomonas syringae)
La présence desdites maladies, mal maîtrisée, menace le rendement mais aussi la réputation qualitative des lots sur les marchés internationaux.
Fondements du Deep Learning appliqué à la phytopathologie
Le deep learning, sous-branche de l’intelligence artificielle, traite l’analyse d’images foliaires via des réseaux de neurones convolutifs (CNN) capables d’extraire caractéristiques visuelles complexes. Ces modèles vont au-delà du simple classement d’images en apprenant à identifier des motifs subtils, spécifiques à chaque pathologie. Les recherches actuelles privilégient des architectures telles que ResNet, VGG ou EfficientNet, connues pour leur robustesse statistique.
Étapes du pipeline d’apprentissage profond
- Collecte d’images de feuilles de caféier, annotées par des experts.
- Prétraitement des images (suppression du bruit, augmentation de données, correction colorimétrique).
- Entraînement du modèle CNN pour distinguer feuilles saines et malades.
- Validation et test sur un ensemble d’images inédites.
Limites actuelles et problématiques de généralisation
Malgré les progrès, plusieurs obstacles entravent la généralisation à grande échelle :
- Variabilité environnementale : luminosité, arrière-plan, stade de la feuille altèrent la qualité des images.
- Données annotées limitées : La constitution de bases d’images couvrant exhaustivement toutes les classes/variétés reste très coûteuse.
- Overfitting : Les modèles surapprennent parfois les données disponibles sans capacité à s’adapter à de nouveaux cas.
- Interprétabilité réduite : Les CNN agissent comme des « boîtes noires », rendant l’explication des résultats difficile pour les utilisateurs finaux.
Des techniques de régularisation, de transfert d’apprentissage et l’intégration de données issues de réseaux collaboratifs sont testées pour pallier ces limites.
Vers une traçabilité renforcée dans le secteur agricole via l’IA
La fiabilité de la détection automatisée s’inscrit au cœur des problématiques de traçabilité qui façonnent le marché du café en e-commerce. Permettre à chaque lot de bénéficier d’une certification numérique de son état phytosanitaire favorise l’instauration de nouvelles normes de transparence :
- Intégration blockchain pour enregistrer, authentifier et tracer les diagnostics associés à chaque lot exporté.
- Rapidité des contrôles sur les flux logistiques, limitant propagation et pertes de qualité.
- Renforcement de la confiance entre producteurs, négociants et consommateurs finaux via un suivi dynamique basé sur l’IA.
Perspectives et recommandations pour l’implémentation pratique
L’industrialisation de ces solutions requiert des efforts coordonnés :
- Élaboration de jeux de données multi-régionaux en collaboration avec les coopératives agricoles.
- Déploiement de modèles légers pouvant être embarqués sur smartphones ou drones.
- Formation des acteurs de terrain à l’usage des technologies de deep learning.
- Collaboration interdisciplinaire pour l’adaptation des outils aux contraintes réelles des plantations.
Les réseaux de neurones doivent être continuellement réentraînés pour intégrer les mutations pathologiques émergentes et renforcer leur capacité de prédiction.
Conclusion
L’emploi du deep learning pour la détection anticipée et automatisée des maladies du caféier s’impose comme un levier d’excellence pour la traçabilité et la maîtrise de la qualité dans l’e-commerce agricole. Malgré des défis méthodologiques persistants – variabilité des données, manque de transparence des modèles, nécessité de bases d’images étoffées – l’intégration progressive de solutions IA dans la chaîne de production promet une transformation durable du secteur caféier. Le futur se dessine autour d’écosystèmes collaboratifs, associant agriculteurs, experts en données et acteurs de la supply chain pour une agriculture connectée, transparente et qualitative.